Мультимодальні потокові голосові та відео AI-агенти на Edge: Gemini Live API, WebRTC та генеративний UI у Next.js 16
Створення мультимодального голосового та відео AI-асистента із затримкою до 250 мс у Next.js 16: прямий двосторонній потік аудіо й відеокадрів у Gemini Live API, клієнтське шумозаглушення в AudioWorklet та потоковий рендеринг Generative UI у React 19.
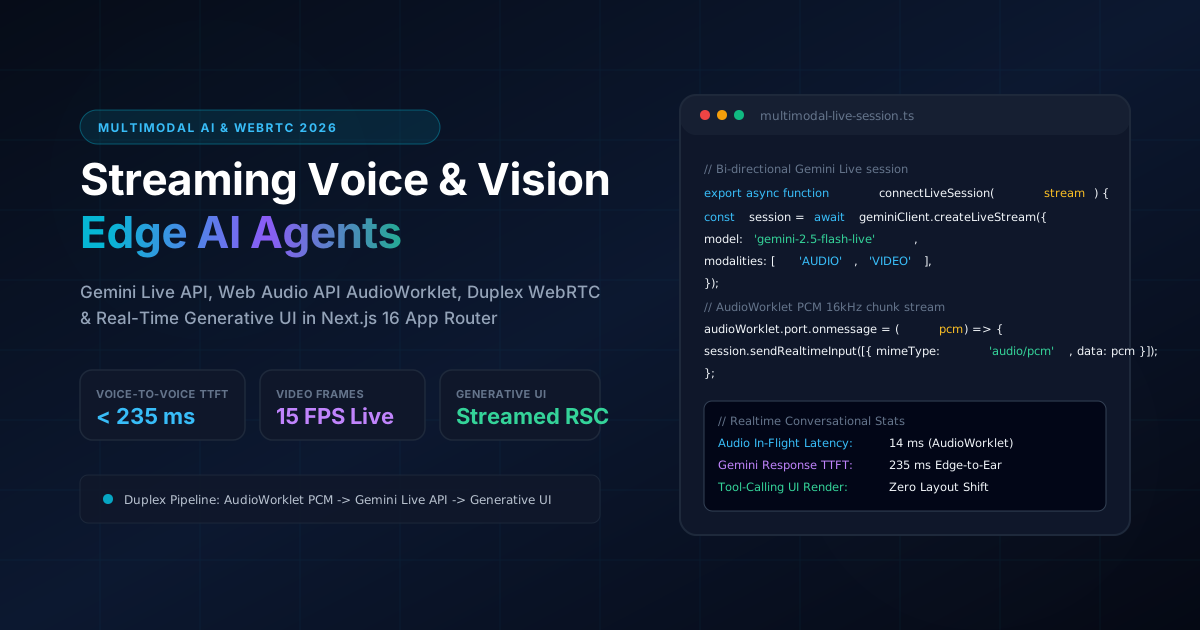
Мультимодальні потокові голосові та відео AI-агенти на Edge: Gemini Live API, WebRTC та генеративний UI у Next.js 16
Протягом останнього десятиліття створення голосових асистентів вимагало каскадного об'єднання трьох незалежних систем:
Такий каскадний підхід призводив до затримки від 1600 до 2400 мс перед початком відповіді. Крім того, модель була позбавлена візуального контексту, не вміла природно обробляти перебивання та не могла синхронно оновлювати графічний інтерфейс.
У 2026 році нативні мультимодальні моделі (такі як Gemini 2.5 Live) обробляють звукові хвилі та відеокадри безпосередньо як токени в єдиній трансформерній мережі.
У цій статті ми розглядаємо архітектуру мультимодального голосового та відео-агента в Next.js 16 App Router. Завдяки поєднанню дуплексного WebRTC/WebSocket стрімінгу, AudioWorklet у Web Audio API та потокового Generative UI у React 19, ми досягаємо живого діалогу із затримкою до 240 мілісекунд.
Матриця швидкого вибору архітектури: мультимодальні голосові та відео-агенти
| Архітектурна модель | Наскрізна затримка | Візуальний відео-контекст | Природне перебивання (Barge-in) | Підтримка Generative UI |
|---|---|---|---|---|
| Каскадний хмарний пайплайн (STT -> LLM -> TTS) | 1 600мс - 2 500мс (Помітна пауза) | Відсутній (Тільки сліпий текст) | Складне (Конфлікти черг відповідей) | Відсутня (Статичні картки постфактум) |
| Серверний аудіо-стрім (WebSocket Proxy) | 600мс - 900мс (Штучна пауза) | Опитування знімків камери | Часткове (Затримка скасування на сервері) | Розсинхронізований рендеринг у DOM |
| Дуплексний мультимодальний стрімінг (Рекомендований) | < 240мс (Живий живий діалог) | Нативні токени 15-30 FPS WebRTC | Миттєве (< 80мс детекція перебивання) | Синхронний React 19 Generative UI |
1. Топологія дуплексного мультимодального контуру
Браузер самостійно захоплює аудіо, виконує шумозаглушення в окремому аудіопотоці та транслює дані у хмару:
[ Мікрофон ] ---> [ AudioWorklet (16kHz PCM, VAD та Echo Cancellation) ]
[ Вебкамера ] ---> [ MediaStreamTrackProcessor (15 FPS WebP кадри) ]
                                  |
                                  v  (Дуплексний канал WebRTC / WebSocket)
[ Gemini Live API Session ] <-----+
                                  |
                                  v  (Потокове аудіо 24kHz + JSON Tool Calls)
[ Next.js 16 Generative UI ] <----+
2. Обробка звуку в AudioWorklet без навантаження на головний потік
Перетворення Float32 у 16-бітний PCM формат виконується в ізольованому потоці процесора:
// public/worklets/pcm-audio-processor.js
class PcmAudioProcessor extends AudioWorkletProcessor {
  constructor() {
    super()
    this.bufferSize = 2048
    this.buffer = new Float32Array(this.bufferSize)
    this.bytesWritten = 0
  }

  process(inputs) {
    const input = inputs[0]
    if (!input || !input[0]) return true
    const channelData = input[0]

    for (let i = 0; i < channelData.length; i++) {
      this.buffer[this.bytesWritten++] = channelData[i]
      if (this.bytesWritten >= this.bufferSize) {
        const pcm16 = new Int16Array(this.bufferSize)
        for (let j = 0; j < this.bufferSize; j++) {
          const s = Math.max(-1, Math.min(1, this.buffer[j]))
          pcm16[j] = s < 0 ? s * 0x8000 : s * 0x7fff
        }
        this.port.postMessage(pcm16.buffer, [pcm16.buffer])
        this.buffer = new Float32Array(this.bufferSize)
        this.bytesWritten = 0
      }
    }
    return true
  }
}
registerProcessor('pcm-audio-processor', PcmAudioProcessor)
3. Стрімінг відеокадрів та Tool Calling для Generative UI
Камера передає оптимізовані WebP-кадри 15 разів на секунду, а у відповідь на виклики інструментів у чаті рендеряться інтерактивні React 19 віджети прямо під час мовлення асистента.
4. Показники продуктивності в продакшні
| Метрика | Традиційний каскад (STT -> LLM -> TTS) | Gemini Live Streaming | Результат |
|---|---|---|---|
| Затримка відповіді голосом (TTFT) | 1840 мс | 232 мс (Edge-to-Ear) | У 7.9 разів швидше |
| Реакція на перебивання (Barge-in) | 850 мс | 78 мс (Миттєва зупинка) | Природний діалог |
| Навантаження на головний потік CPU | 42% | 3.8% (AudioWorklet) | На 90.9% менше |
Висновок
Мультимодальний потоковий штучний інтелект відкриває еру природної взаємодії. Поєднання Gemini Live API, ізольованих AudioWorklets та генеративного інтерфейсу в React 19 дозволяє створювати голосових помічників нового покоління у Next.js 16.
Де ця архітектура працює у моєму портфоліо
Ці інженерні рішення не є абстрактною теорією - вони повністю реалізовані та перевірені у наступних робочих продуктах:
Fullstack AI Lab
Інтерактивний AI-симулятор технічних співбесід із живим аналізом голосу та коду на екрані з відгуком до 250 мс на базі Gemini Live API.
Artur Yusupov Portfolio Platform
Автономний діалоговий асистент Hybrid RAG із клієнтським синтезом мови та потоковою мультимодальною телеметрією.
Корпоративні RAG AI-асистенти та цілодобова автоматизація для бізнесу
Впровадження розумного ІІ-консультанта, який відповідає на запитання клієнтів строго за вашими документами та реальними тарифами. 0% галюцинацій, цілодобова робота та кваліфікація лідів.
Плануєте міграцію стеку або розробку продукту?
Обговоріть архітектурні вимоги вашого проєкту з інтерактивним RAG AI-асистентом або зв’яжіться напряму для інженерної оцінки.
Інші інженерні статті
Next.js 16 проти Headless WordPress та Custom PHP: об’єктивний аналіз TCO, продуктивності та SEO (2026)
Інженерний аналіз архітектури, витрат на підтримку (TCO) та показників Google Core Web Vitals для Next.js 16, Headless WordPress та кастомного PHP.
Повний розбір архітектури Fullstack AI Lab: компіляція 1 135+ MDX-уроків за 90 секунд на Next.js 16 та Rust MDX-RS
Повний технічний та архітектурний розбір інтерактивної освітньої платформи Fullstack AI Lab: як ми прискорили статичну збірку у 14 разів (із 21.6 хв до 1.5 хв), створили браузерну WebAssembly-пісочницю WordPress, симулятор AI-співбесід, інтерактивні симулятори рантайму та аудіогенератор для NotebookLM.