Local-First LLM у браузері через WebGPU: інференс без серверів та повна приватність у веб-застосунках
Глибокий інженерний розбір запуску квантованих мовних моделей на 1B-3B параметрів (Llama 3.2, Gemma 2, SmolLM2) безпосередньо у браузері клієнта через WebGPU, Transformers.js v3 та ONNX Runtime Web: нульові витрати на серверний інференс та повна конфіденційність.
1. Зміна парадигми: чому Local-First AI перемагає
Протягом останніх років типовим патерном розробки AI-застосунків був централізований хмарний інференс: клієнт надсилає промпт через HTTPS на сторонній сервер (OpenAI, Anthropic тощо), чекає мережевої відповіді та приймає потік токенів.
У 2026 році спостерігається масовий перехід до Local-First AI у браузері:
Матриця вибору архітектури AI: хмарні API проти локального WebGPU у браузері
| Архітектурний вимір | Централізовані хмарні API (OpenAI / Claude) | Локальний WebGPU у браузері (Local-First) |
|---|---|---|
| Витрати на інференс | $0.002 - $0.015 за запит (Лінійне зростання) | $0.00 (Нуль витрат на хмарні сервери) |
| Приватність даних | Передача через мережу (Ризик витоків) | 100% Конфіденційність (Дані не виходять з пристрою) |
| Офлайн-автономність | Повна непрацездатність без інтернету | 100% Офлайн-робота у форматі PWA |
| Швидкість генерації | Обмежена мережевою затримкою (TTFB) | 28 - 45 токенів/с (Апаратне прискорення GPU) |
| Початкове завантаження | Нульове завантаження моделі (Миттєвий старт) | 600 - 750 МБ (Одноразове збереження в кеш браузера) |
2. Технологічний прорив: WebGPU замість WebGL
Раніше машинне навчання в браузері базувалося на WebGL, де матричні обчислення доводилося маскувати під шейдери рендерингу пікселів.
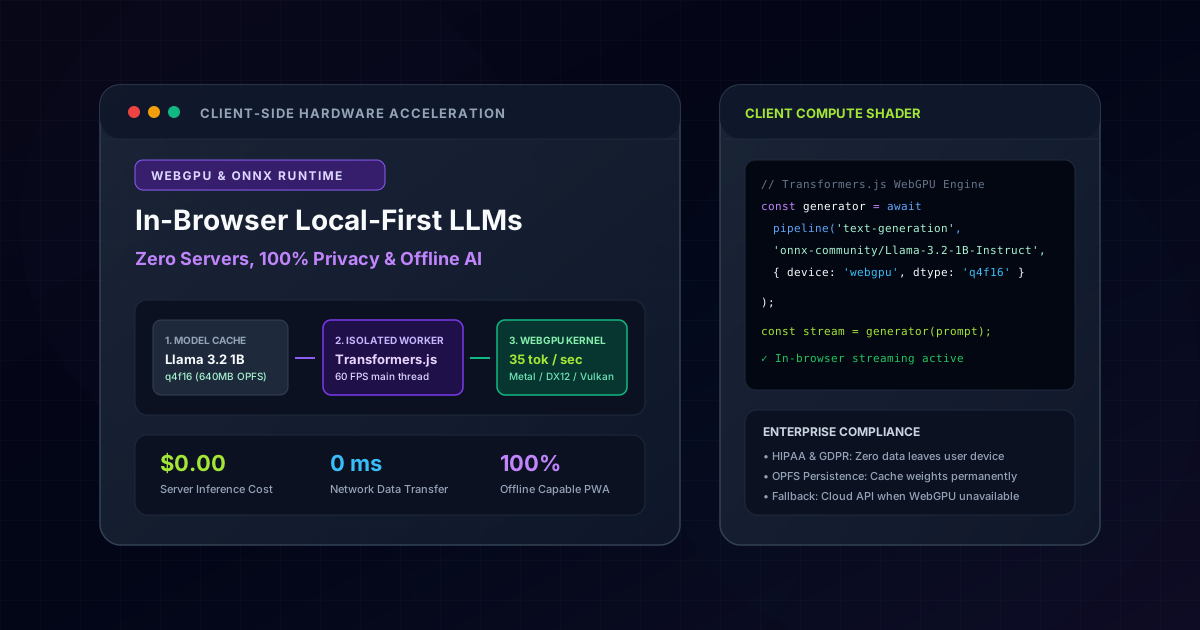
WebGPU відкриває прямий доступ до апаратного прискорювача через нативні Compute Shaders на мові WGSL, підтримує 16-бітну математику (f16) та працює через Metal, DirectX 12 та Vulkan зі швидкістю до 35-50 токенів на секунду.
3. Запуск квантованих моделей через Transformers.js v3
Сучасні компактні моделі, такі як Llama 3.2 1B чи SmolLM2, квантовані до 4 біт (q4f16), займають всього 650-750 МБ пам яті при збереженні високої якості логіки.
Бібліотека Transformers.js v3 ініціалізує конвеєр за декілька рядків:
import { pipeline } from '@huggingface/transformers';

const generator = await pipeline(
  'text-generation',
  'onnx-community/Llama-3.2-1B-Instruct',
  { device: 'webgpu', dtype: 'q4f16' }
);
4. Ізоляція у Web Worker для стабільних 60 FPS
Виконання нейромережевих обчислень в основному потоці блокує інтерфейс користувача. Перенесення інференсу у фоновий Web Worker гарантує плавну анімацію та збереження 60 FPS у React під час генерації тексту.
5. Гібридна архітектура відмовостійкості
У реальних проєктах застосовується гібридний патерн:
- Якщо браузер підтримує WebGPU та має достатньо оперативної пам яті - працює локальна модель ($0 витрат, максимальна приватність).
- Для застарілих браузерів або слабких пристроїв система плавно перемикається на хмарний API (Gemini / Claude).
Де ця архітектура працює у моєму портфоліо
Ці інженерні рішення не є абстрактною теорією - вони повністю реалізовані та перевірені у наступних робочих продуктах:
Next.js 16 & Hybrid RAG Portfolio Platform
Використовує клієнтський браузерний семантичний векторний пошук із розрахунком косинусної подібності та офлайн-базою знань.
Fullstack AI Lab
Містить інтерактивні браузерні пісочниці нейромереж на WebGPU із генерацією токенів без серверів та живим налаштуванням параметрів.
All Day Medical Care Clinic
Дослідницька архітектура для медичних даних із нульовим витоком інформації, де аналіз симптомів виконується локально на пристрої пацієнта.
Плануєте міграцію стеку або розробку продукту?
Обговоріть архітектурні вимоги вашого проєкту з інтерактивним RAG AI-асистентом або зв’яжіться напряму для інженерної оцінки.
Інші інженерні статті
Next.js 16 проти Headless WordPress та Custom PHP: об’єктивний аналіз TCO, продуктивності та SEO (2026)
Інженерний аналіз архітектури, витрат на підтримку (TCO) та показників Google Core Web Vitals для Next.js 16, Headless WordPress та кастомного PHP.
Повний розбір архітектури Fullstack AI Lab: компіляція 1 135+ MDX-уроків за 90 секунд на Next.js 16 та Rust MDX-RS
Повний технічний та архітектурний розбір інтерактивної освітньої платформи Fullstack AI Lab: як ми прискорили статичну збірку у 14 разів (із 21.6 хв до 1.5 хв), створили браузерну WebAssembly-пісочницю WordPress, симулятор AI-співбесід, інтерактивні симулятори рантайму та аудіогенератор для NotebookLM.