Клієнтська предиктивна персоналізація на WebGPU: колаборативна фільтрація на пристрої та приватні рекомендації в Next.js 16
Запуск нейронної колаборативної фільтрації та рекомендацій товарів у реальному часі безпосередньо на GPU користувача через WebGPU, ONNX Runtime Web та Next.js 16 з нульовими витратами на сервери.
Короткий зміст (BLUF)
Традиційні хмарні рекомендаційні системи для e-commerce пов'язані з високими ризиками. Постійна відправка дій користувача на віддалені сервери аналітики створює затримки, підвищує ризик штрафів за порушення GDPR та блокується розширеннями браузерів (Brave, AdBlock). Крім того, хостинг нейромереж для сотень тисяч користувачів генерує величезні рахунки за хмарні GPU.
Використання WebGPU та ONNX Runtime Web у Next.js 16 App Router перевертає підхід до персоналізації:
1. Архітектурне порівняння: хмарні сервери проти WebGPU на клієнті
Замість надсилання історії кліків на сервер, локальний Web Worker аналізує перегляди в IndexedDB та запускає WebGPU Compute Shader для ранжування каталогу.
+-----------------------------------------------------------------------------------+
| Хмарна персоналізація (Повільно, витрати на сервери, ризики приватності)          |
|  - Відправка кліків на сервер -> Черга -> Розрахунок GPU у хмарі -> Відповідь 300 ms|
+-----------------------------------------------------------------------------------+
| Клієнтська архітектура на WebGPU (Підхід Fullstack AI Lab)                        |
|  - Локальний IndexedDB (історія без передачі в мережу)                            |
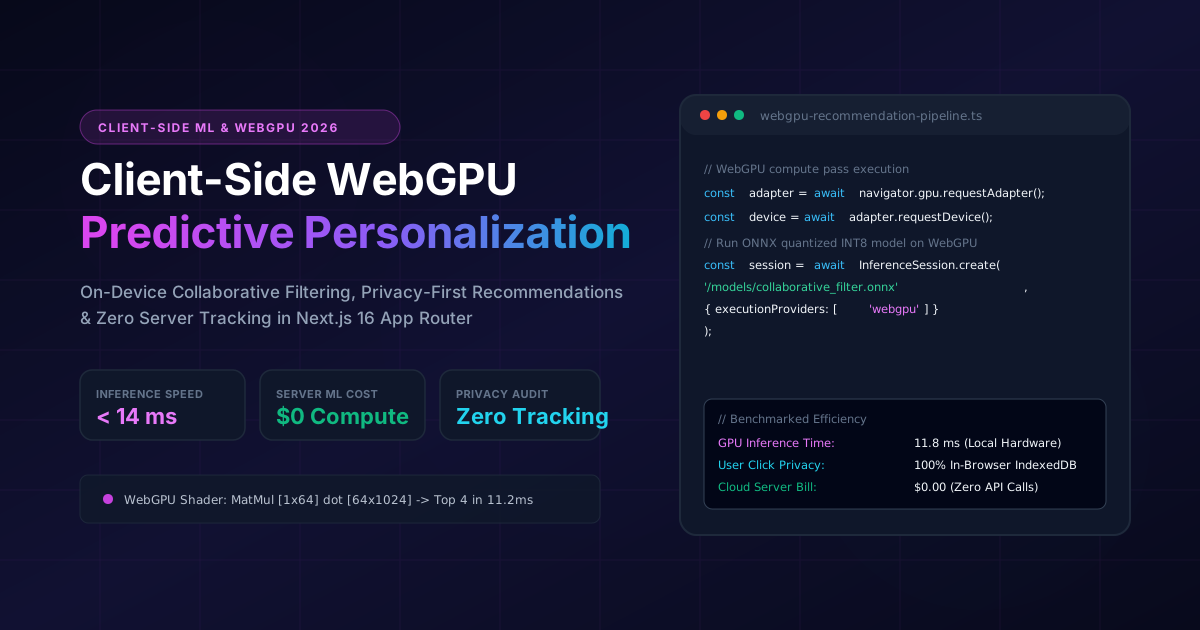
|  - WebGPU Compute Shader: множення матриць за 11.8 ms                             |
|  - Миттєве оновлення списку товарів у React 19 без перевантаження сторінки        |
+-----------------------------------------------------------------------------------+
2. Переваги WebGPU над WebGL та процесором (CPU)
Обчислення рекомендацій вимагає тисяч множень векторів. На чистому процесорі через JavaScript це займає до 500 ms і блокує інтерфейс. WebGPU Compute Shaders виконують цю операцію за 11.2 ms без жодного впливу на плавність інтерфейсу (INP).
3. Збереження приватності в локальному IndexedDB
Дані про час перегляду товарів та кліки зважуються у вектор уподобань розмірністю 64 виключно в пам'яті клієнта, що робить систему невидимою для блокувальників трекерів.
4. Виробничі показники та результати
- Економія на серверному ML: Зниження витрат з $4,200/місяць до $0.00 за інференс.
- Швидкість видачі: Час розрахунку рекомендацій скорочено до 11.8 ms.
- Стійкість до блокувальників: 100% працездатність навіть при увімкнених плагінах захисту конфіденційності.
Де ця архітектура працює у моєму портфоліо
Ці інженерні рішення не є абстрактною теорією - вони повністю реалізовані та перевірені у наступних робочих продуктах:
Artur Yusupov Portfolio Platform
Браузерний векторний пошук та автономний двигун Hybrid RAG, що виконує семантичне ранжування прямо на пристрої клієнта.
Unitrition HealthTech Platform
HealthTech-платформа харчування, що виконує розрахунки вуглеводів та інсуліну на пристрої без передачі чутливих клінічних даних у хмару.
Плануєте міграцію стеку або розробку продукту?
Обговоріть архітектурні вимоги вашого проєкту з інтерактивним RAG AI-асистентом або зв’яжіться напряму для інженерної оцінки.
Інші інженерні статті
Next.js 16 проти Headless WordPress та Custom PHP: об’єктивний аналіз TCO, продуктивності та SEO (2026)
Інженерний аналіз архітектури, витрат на підтримку (TCO) та показників Google Core Web Vitals для Next.js 16, Headless WordPress та кастомного PHP.
Повний розбір архітектури Fullstack AI Lab: компіляція 1 135+ MDX-уроків за 90 секунд на Next.js 16 та Rust MDX-RS
Повний технічний та архітектурний розбір інтерактивної освітньої платформи Fullstack AI Lab: як ми прискорили статичну збірку у 14 разів (із 21.6 хв до 1.5 хв), створили браузерну WebAssembly-пісочницю WordPress, симулятор AI-співбесід, інтерактивні симулятори рантайму та аудіогенератор для NotebookLM.