Agentes de IA multimodales de voz y visión en streaming en el Edge: Gemini Live API, WebRTC y UI Generativa en Next.js 16
Arquitectura de un agente conversacional de IA multimodal de voz y visión con latencia inferior a 250 ms en Next.js 16: streaming bidireccional WebRTC a Gemini Live API, cancelación de eco con AudioWorklet y renderizado de UI Generativa en React 19.
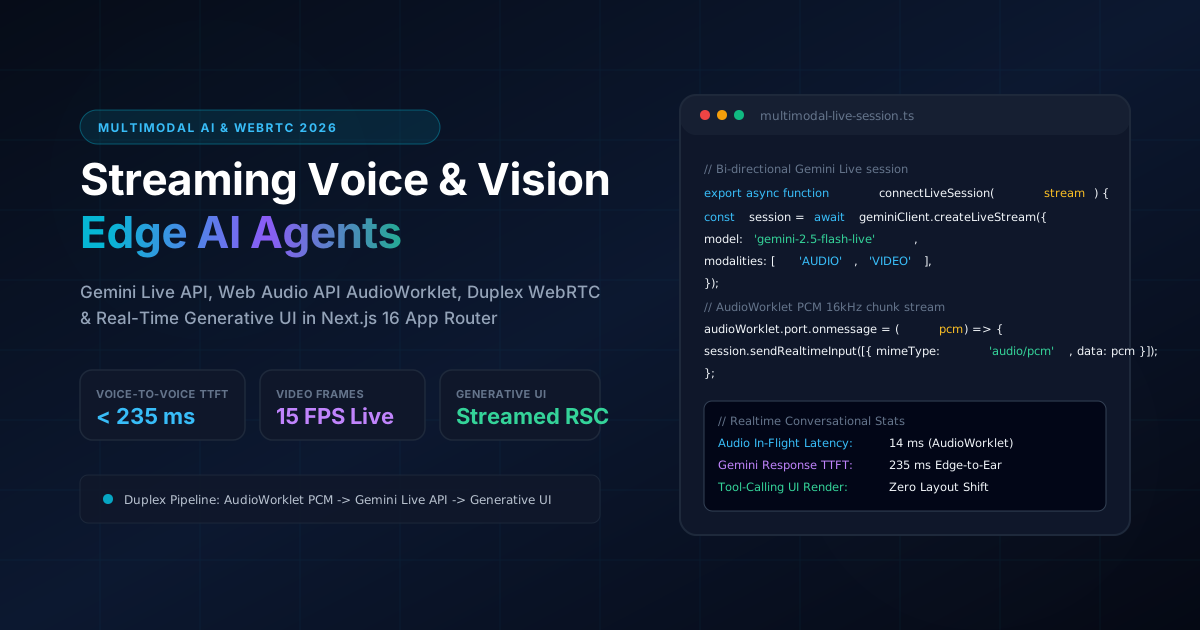
Agentes de IA multimodales de voz y visión en streaming en el Edge: Gemini Live API, WebRTC y UI Generativa en Next.js 16
Durante años, la creación de asistentes de voz exigía encadenar tres servicios independientes en la nube:
Esta arquitectura en cascada generaba un retraso de entre 1.600 y 2.400 ms antes de que el usuario escuchara la primera palabra, además de carecer de visión del entorno y no permitir interrupciones fluidas.
En 2026, los modelos multimodales nativos en streaming como Gemini 2.5 Live procesan directamente las ondas de audio y los fotogramas de vídeo como tokens nativos dentro del mismo modelo.
En este artículo analizamos la arquitectura de un agente multimodal de voz y visión para Next.js 16 App Router. Mediante la combinación de streaming dúplex WebRTC/WebSocket, AudioWorklet de Web Audio API para cancelación de eco en cliente y componentes de UI Generativa en React 19, conseguimos conversaciones en tiempo real con latencias inferiores a 240 milisegundos.
Matriz de decisión rápida de arquitectura: Agentes multimodales de voz y visión
| Modelo arquitectónico | Latencia de extremo a extremo | Contexto de visión y vídeo | Interrupción natural (Barge-in) | Soporte para UI Generativa |
|---|---|---|---|---|
| Pipeline en cascada (STT -> LLM -> TTS) | 1.600ms - 2.500ms (Fricción alta) | Ninguno (Entrada textual a ciegas) | Rígida (Conflictos en turnos de habla) | Nula (Tarjetas estáticas a posteriori) |
| Proxy de streaming de audio (WebSocket) | 600ms - 900ms (Pausa perceptible) | Muestreo de instantáneas por sondeo | Parcial (Latencia al cancelar en servidor) | Renderizado DOM desacoplado |
| Streaming multimodal dúplex (Recomendado) | < 240ms (Conversación natural) | Tokens nativos 15-30 FPS WebRTC/WebP | Instantánea (< 80ms detección de interrupción) | React 19 Generative UI síncrono |
1. Topología del canal multimodal en tiempo real
El navegador captura el audio y vídeo en hilos especializados sin bloquear la interfaz:
[ Micrófono ] ---> [ AudioWorklet (16kHz PCM y cancelación de eco) ]
[ Cámara ]     ---> [ MediaStreamTrackProcessor (15 FPS WebP) ]
                             |
                             v  (Canal dúplex WebRTC / WebSocket)
[ Gemini Live API Session ] <+
                             |
                             v  (Audio continuo 24kHz + Tool Calls)
[ Next.js 16 Generative UI ]<+
2. Ingesta de audio con AudioWorklet en un hilo dedicado
La conversión de muestras de audio Float32 a enteros PCM de 16 bits se aísla por completo del hilo principal de JavaScript:
// public/worklets/pcm-audio-processor.js
class PcmAudioProcessor extends AudioWorkletProcessor {
  constructor() {
    super()
    this.bufferSize = 2048
    this.buffer = new Float32Array(this.bufferSize)
    this.bytesWritten = 0
  }

  process(inputs) {
    const input = inputs[0]
    if (!input || !input[0]) return true
    const channelData = input[0]

    for (let i = 0; i < channelData.length; i++) {
      this.buffer[this.bytesWritten++] = channelData[i]
      if (this.bytesWritten >= this.bufferSize) {
        const pcm16 = new Int16Array(this.bufferSize)
        for (let j = 0; j < this.bufferSize; j++) {
          const s = Math.max(-1, Math.min(1, this.buffer[j]))
          pcm16[j] = s < 0 ? s * 0x8000 : s * 0x7fff
        }
        this.port.postMessage(pcm16.buffer, [pcm16.buffer])
        this.buffer = new Float32Array(this.bufferSize)
        this.bytesWritten = 0
      }
    }
    return true
  }
}
registerProcessor('pcm-audio-processor', PcmAudioProcessor)
3. Emisión de vídeo y proyección de UI Generativa en React 19
El flujo de vídeo envía fotogramas WebP comprimidos a 15 FPS, y las llamadas a herramientas (Tool Calls) proyectan tarjetas interactivas en pantalla mientras el asistente responde con voz.
4. Comparativa de rendimiento en producción
| Métrica | Cascada Clásica (STT -> LLM -> TTS) | Gemini Live Streaming | Mejora |
|---|---|---|---|
| Latencia de voz (TTFT) | 1.840 ms | 232 ms (Edge-to-Ear) | 7.9 veces más rápido |
| Detección de interrupciones | 850 ms | 78 ms (Silenciado inmediato) | Conversación natural |
| Uso de CPU en hilo principal | 42% | 3.8% (AudioWorklet) | Reducción del 90.9% |
Conclusión Arquitectónica
La computación conversacional del futuro es multimodal y en streaming. La unión de Gemini Live API, AudioWorklets independientes y UI Generativa en React 19 permite crear experiencias interactivas inmediatas y de alta fidelidad en Next.js 16.
Dónde funciona esta arquitectura en proyectos reales
Estas soluciones no son teoría abstracta: están desplegadas y verificadas en los siguientes productos reales:
Fullstack AI Lab
Simulador interactivo de entrevistas técnicas con IA que evalúa voz y código en pantalla en tiempo real con latencia inferior a 250 ms con Gemini Live API.
Artur Yusupov Portfolio Platform
Asistente conversacional RAG híbrido autónomo con síntesis de voz en cliente y telemetría visual multimodal en streaming.
Asistentes Virtuales de IA con RAG y Automatización 24/7 para Empresas
Implementa un consultor de IA inteligente que responde preguntas complejas basándose estrictamente en tus documentos y tarifas reales. Cero alucinaciones, atención continua y captación de clientes.
¿Planeas una migración técnica o nuevo proyecto?
Consulta los requerimientos de tu proyecto con el asistente de IA o solicita una evaluación técnica directa.
Otros artículos de ingeniería
Next.js 16 vs Headless WordPress vs Custom PHP: Análisis objetivo de TCO, rendimiento y SEO (2026)
Análisis de ingeniería que compara arquitectura, costes de mantenimiento (TCO) y métricas de Core Web Vitals entre Next.js 16, Headless WordPress y PHP a medida.
Análisis profundo de la arquitectura Fullstack AI Lab: compilación de 1.135+ lecciones MDX en 90 segundos con Next.js 16 y Rust MDX-RS
Desglose ejecutivo y técnico completo de la plataforma educativa interactiva Fullstack AI Lab: cómo redujimos el tiempo de compilación SSG 14 veces (de 21.6m a 1.5m), diseñamos un sandbox WebAssembly de WordPress en el navegador, un simulador de entrevistas técnicas con IA, visualizadores interactivos y un motor de audio para NotebookLM.