LLMs locales en el navegador mediante WebGPU: inferencia sin servidores y privacidad total en aplicaciones web
Análisis arquitectónico sobre la ejecución de modelos de lenguaje cuantizados de 1B-3B parámetros (Llama 3.2, Gemma 2, SmolLM2) directamente en el navegador del cliente mediante WebGPU, Transformers.js v3 y ONNX Runtime Web: coste cero de servidores y privacidad absoluta.
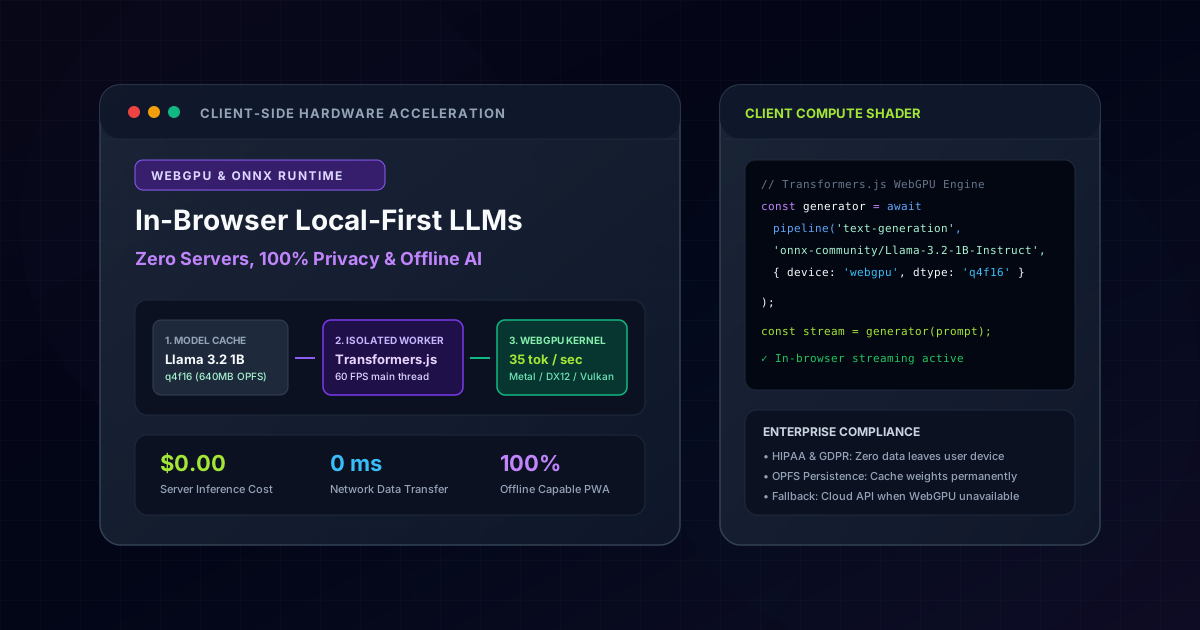
1. Cambio de paradigma: por qué el Local-First AI transforma la web
Durante años, la arquitectura estándar de IA ha dependido de servidores centralizados en la nube: el cliente envía datos sensibles mediante HTTPS, asume costes recurrentes de GPU y depende de la estabilidad de la red.
En 2026, el enfoque Local-First en el navegador ofrece tres ventajas decisivas:
- Coste cero de infraestructura: El cómputo corre a cargo del hardware del usuario ($0.00 en factura de servidores).
- Privacidad total: Datos confidenciales bajo normativas HIPAA o GDPR nunca salen del dispositivo del cliente.
- Funcionamiento 100% offline: Aplicaciones PWA que responden sin conexión a internet.
Matriz de decisión de arquitectura IA: APIs en la nube vs WebGPU local en navegador
| Dimensión arquitectónica | APIs centralizadas en la nube (OpenAI) | WebGPU local en el navegador (Local-First) |
|---|---|---|
| Coste de infraestructura | $0.002 - $0.015 por petición (Escalado lineal) | $0.00 (Cero costes en servidores GPU) |
| Privacidad de datos | Envío a servidores externos (Riesgo GDPR/HIPAA) | 100% Privacidad en cliente (Cero salida de datos) |
| Disponibilidad offline | Inutilizable ante pérdida de conexión | 100% Funcional sin red en aplicaciones PWA |
| Velocidad de generación | Limitada por la latencia de red (TTFB) | 28 - 45 tokens/s (Aceleración hardware cliente) |
| Carga inicial de modelos | Sin descarga de modelo (Arranque inmediato) | 600MB - 750MB (Descarga única en caché de navegador) |
2. WebGPU frente a WebGL
WebGPU introduce Compute Shaders nativos en WGSL, soporte para operaciones de punto flotante de 16 bits (f16) y acceso directo a APIs de bajo nivel (Metal, DirectX 12, Vulkan), multiplicando la velocidad de inferencia hasta alcanzar 35-50 tokens por segundo.
3. Modelos ligeros con Transformers.js v3
Modelos como Llama 3.2 1B y SmolLM2, cuantizados a 4 bits (q4f16), ocupan entre 600MB y 750MB en disco y ofrecen capacidades de razonamiento excepcionales en dispositivos móviles y portátiles.
4. Aislamiento en Web Workers y arquitectura híbrida
Ejecutar la inferencia en un Web Worker dedicado evita congelar el hilo principal de renderizado en React, manteniendo 60 FPS constantes. Si el dispositivo no cuenta con aceleración WebGPU, el sistema conmuta automáticamente hacia la API en la nube como mecanismo de fallback transparente.
Dónde funciona esta arquitectura en proyectos reales
Estas soluciones no son teoría abstracta: están desplegadas y verificadas en los siguientes productos reales:
Next.js 16 & Hybrid RAG Portfolio Platform
Implementa búsqueda vectorial semántica en el navegador con cálculo de similitud coseno y base de conocimiento offline.
Fullstack AI Lab
Ofrece entornos de experimentación con redes neuronales sobre WebGPU sin servidores y ajuste de hiperparámetros en tiempo real.
All Day Medical Care Clinic
Arquitectura médica con cero exfiltración de datos donde el análisis de síntomas se procesa localmente en el dispositivo para garantizar HIPAA.
¿Planeas una migración técnica o nuevo proyecto?
Consulta los requerimientos de tu proyecto con el asistente de IA o solicita una evaluación técnica directa.
Otros artículos de ingeniería
Next.js 16 vs Headless WordPress vs Custom PHP: Análisis objetivo de TCO, rendimiento y SEO (2026)
Análisis de ingeniería que compara arquitectura, costes de mantenimiento (TCO) y métricas de Core Web Vitals entre Next.js 16, Headless WordPress y PHP a medida.
Análisis profundo de la arquitectura Fullstack AI Lab: compilación de 1.135+ lecciones MDX en 90 segundos con Next.js 16 y Rust MDX-RS
Desglose ejecutivo y técnico completo de la plataforma educativa interactiva Fullstack AI Lab: cómo redujimos el tiempo de compilación SSG 14 veces (de 21.6m a 1.5m), diseñamos un sandbox WebAssembly de WordPress en el navegador, un simulador de entrevistas técnicas con IA, visualizadores interactivos y un motor de audio para NotebookLM.