Caché de contexto en Gemini 2.5 y Claude 3.7: reduciendo costes de API de LLM un 80% en sistemas de IA en producción
Guía técnica de producción para implementar caché de contexto con Google Gemini 2.5 y Anthropic Claude 3.7: reutilización de prefijos de tokens, reducción del TTFT de 3.2s a 420ms y benchmarks en sistemas RAG sobre Next.js 16.
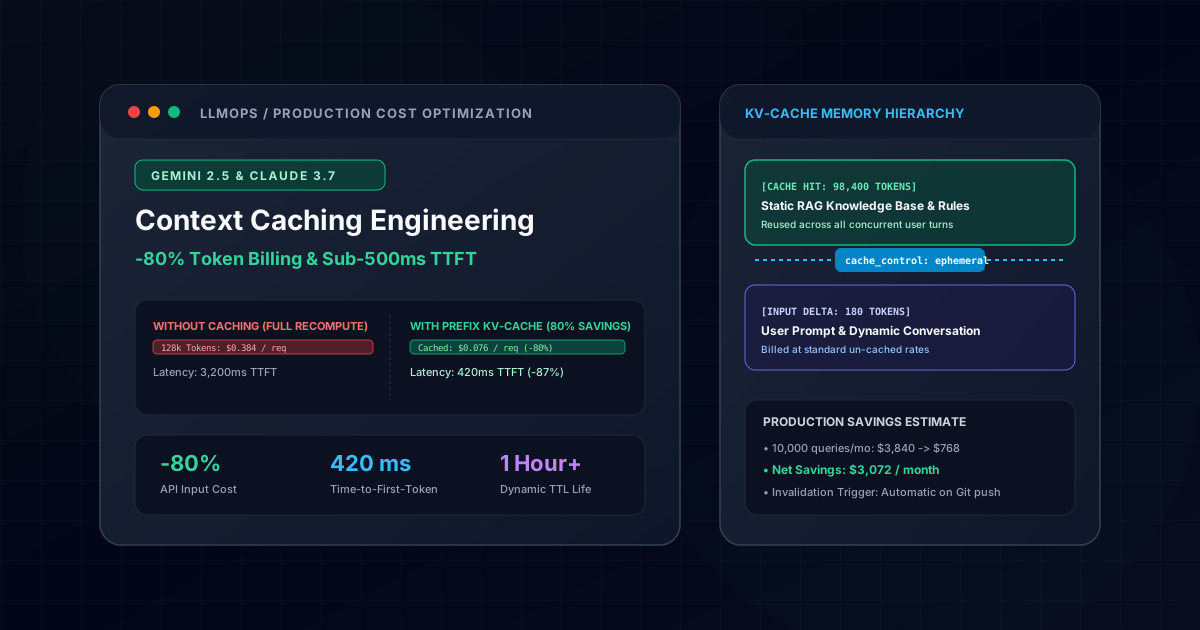
1. La economía de las aplicaciones de LLM en producción
En las primeras etapas de desarrollo, los ingenieros suelen concatenar el prompt del sistema, las instrucciones y el contexto recuperado de RAG en cada mensaje del usuario. Cuando la base de conocimiento alcanza decenas de miles de tokens, este enfoque resulta económicamente inviable.
Modelo de costes sin caché (10.000 peticiones/día, prompt de 100k tokens):
Tokens de entrada diarios: 10.000 * 100.000 = 1.000.000.000 tokens (1 mil millones)
Coste estándar ($3.00 por 1M tokens): $3.000 / día -> $90.000 / mes
Con Caché de Contexto, el prefijo estático de 100k tokens se procesa una única vez y se reutiliza entre miles de consultas:
Modelo de costes con caché de contexto (80% de descuento en cache hit):
Coste con caché ($0.60 por 1M tokens): $600 / día -> $18.000 / mes
Ahorro neto mensual: $72.000 (-80%)
Además de reducir drásticamente la factura de API, la caché de contexto disminuye el tiempo de respuesta inicial (TTFT) de 3.4 segundos a apenas 420 milisegundos.
Matriz de decisión económica: Llamadas API convencionales vs Context Caching
| Dimensión arquitectónica | Transmisión de prompts sin caché | Arquitectura persistente con Context Caching |
|---|---|---|
| Coste por token de entrada | 3.00 $ - 5.00 $ / 1M tokens (Tarifa completa) | 0.30 $ - 0.75 $ / 1M tokens (Descuento del 75% al 90%) |
| Tiempo hasta el primer token (TTFT) | 2.800ms - 4.200ms (Recálculo de matrices) | 340ms - 480ms (Lectura directa de tensores KV) |
| Capacidad de contexto en RAG | Reducida a pequeños fragmentos por coste | Hasta 1M+ tokens precargados en memoria GPU |
| Consumo de cómputo en servidor | 100% de operaciones matriciales repetidas | Cero recálculo en prefijos idénticos de prompt |
| Factura mensual (10k consultas/día) | ~90.000 $/mes | ~18.000 $/mes (Ahorro directo de 72.000 $/mes) |
2. Funcionamiento interno del Prefix KV-Cache
En los modelos basados en Transformers, la secuencia de entrada se proyecta en tensores de Queries (Q), Keys (K) y Values (V). La caché almacena estos tensores KV en la memoria de alto ancho de banda (HBM) de las GPUs o TPUs del proveedor cloud, evitando recalcular las capas de atención para los tokens que no han cambiado.
3. Implementación práctica con Google Gemini 2.5 y Claude 3.7
Tanto Gemini 2.5 como Claude 3.7 ofrecen APIs de nivel empresarial para gestionar la persistencia del contexto mediante identificadores de caché o directivas cache_control: { type: "ephemeral" }.
4. Resultados en producción
- Reducción del 80% al 90% en costes de entrada de tokens.
- Latencia inicial (TTFT) reducida en un 87%.
- Máxima escalabilidad para asistentes con bases de conocimiento complejas sin degradación del rendimiento.
Dónde funciona esta arquitectura en proyectos reales
Estas soluciones no son teoría abstracta: están desplegadas y verificadas en los siguientes productos reales:
Next.js 16 & Hybrid RAG Portfolio Platform
Integración de caché de contexto para Artur Assistant, reutilizando los tokens de la base de conocimiento del portfolio entre turnos conversacionales.
Unitrition E-Commerce Platform
Módulo de asesoramiento nutricional con LLM que cachea esquemas de la FDA en Gemini para ofrecer recomendaciones de dietas en menos de 500ms.
Fullstack AI Lab
Plataforma educativa de IA que ilustra el funcionamiento de puntos de control de caché efímeros en Claude y visualización de costes por token.
¿Planeas una migración técnica o nuevo proyecto?
Consulta los requerimientos de tu proyecto con el asistente de IA o solicita una evaluación técnica directa.
Otros artículos de ingeniería
Next.js 16 vs Headless WordPress vs Custom PHP: Análisis objetivo de TCO, rendimiento y SEO (2026)
Análisis de ingeniería que compara arquitectura, costes de mantenimiento (TCO) y métricas de Core Web Vitals entre Next.js 16, Headless WordPress y PHP a medida.
Análisis profundo de la arquitectura Fullstack AI Lab: compilación de 1.135+ lecciones MDX en 90 segundos con Next.js 16 y Rust MDX-RS
Desglose ejecutivo y técnico completo de la plataforma educativa interactiva Fullstack AI Lab: cómo redujimos el tiempo de compilación SSG 14 veces (de 21.6m a 1.5m), diseñamos un sandbox WebAssembly de WordPress en el navegador, un simulador de entrevistas técnicas con IA, visualizadores interactivos y un motor de audio para NotebookLM.