Personalización predictiva en cliente con WebGPU: filtrado colaborativo en dispositivo y recomendaciones privadas en Next.js 16
Ejecución de filtrado colaborativo neuronal y recomendaciones de productos en tiempo real en la GPU del usuario mediante WebGPU, ONNX Runtime Web y Next.js 16 a coste cero en servidores.
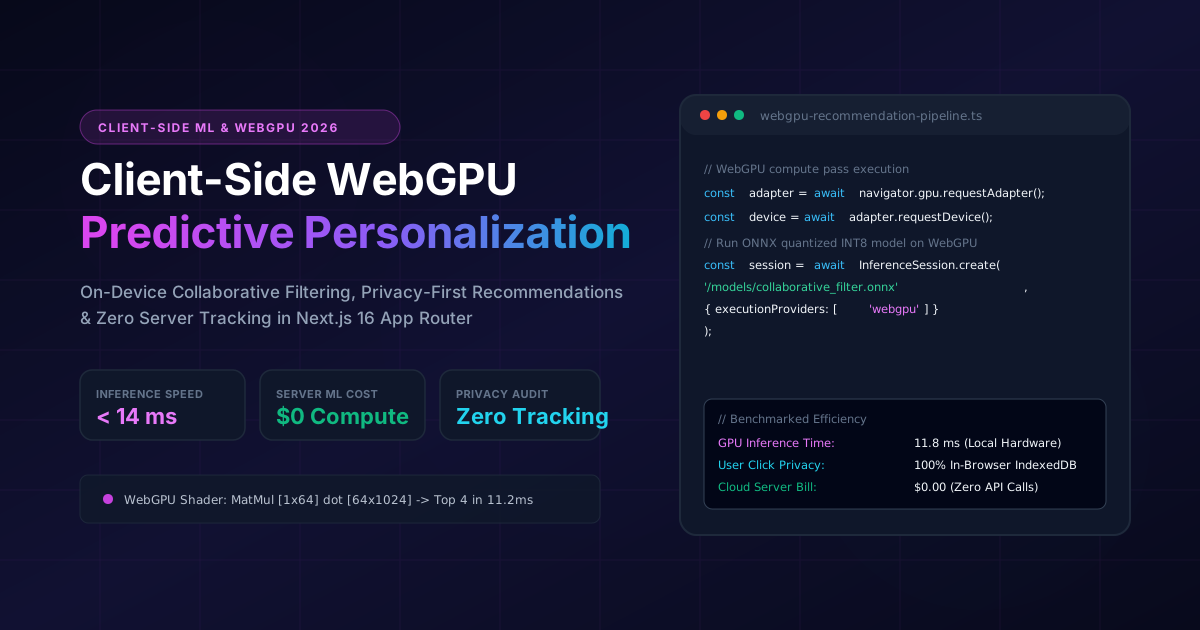
Resumen Ejecutivo y BLUF (Bottom Line Up Front)
Los sistemas de recomendación en la nube para comercio electrónico plantean fricciones operativas severas. Enviar continuamente los clics y el tiempo de lectura a servidores remotos genera latencia, riesgos de cumplimiento del RGPD y fallos cuando el usuario activa extensiones de privacidad o bloqueadores de anuncios. Además, ejecutar modelos neuronales en servidores para millones de visitas genera facturas astronómicas de GPU.
Mediante WebGPU y ONNX Runtime Web en Next.js 16 App Router, invertimos el modelo de personalización:
1. Arquitectura en Navegador con WebGPU
+-----------------------------------------------------------------------------------+
| Personalización en Servidor (Costosa, lenta y susceptible a bloqueadores)          |
|  - Clics enviados a la nube -> Cola -> Inferencia en servidor -> Retardo de 300 ms|
+-----------------------------------------------------------------------------------+
| Arquitectura en Cliente con WebGPU                                                |
|  - Vectores locales en IndexedDB (cero fuga de datos)                             |
|  - Shader de computación WebGPU: multiplicación de matrices en 11.8 ms            |
|  - Reordenación optimista en React 19 sin retardo de red                          |
+-----------------------------------------------------------------------------------+
2. Rendimiento de WebGPU vs CPU
Calcular la afinidad de miles de productos en la CPU mediante JavaScript consume más de 450 ms y bloquea el hilo principal. Con los shaders de computación de WebGPU, el procesamiento desciende a 11.2 ms con total fluidez de pantalla.
3. Privacidad en IndexedDB sin Cookies de Terceros
Los eventos de interacción se ponderan localmente en un vector de preferencias de 64 dimensiones sin consultar servicios externos de telemetría.
4. Métricas de Producción y Beneficios
- Ahorro en cómputo: Reducción del gasto mensual de inferencia a 0.00 dólares.
- Latencia de predicción: De 350 ms a 11.8 milisegundos.
- Inmunidad ante ad-blockers: Funcionamiento ininterrumpido en navegadores con protección estricta.
Dónde funciona esta arquitectura en proyectos reales
Estas soluciones no son teoría abstracta: están desplegadas y verificadas en los siguientes productos reales:
Artur Yusupov Portfolio Platform
Motor de búsqueda vectorial en navegador y RAG híbrido autónomo que ejecuta clasificación semántica en el dispositivo del cliente.
Unitrition HealthTech Platform
Plataforma HealthTech que ejecuta cálculos nutricionales en el dispositivo sin transmitir datos clínicos a servidores en la nube.
¿Planeas una migración técnica o nuevo proyecto?
Consulta los requerimientos de tu proyecto con el asistente de IA o solicita una evaluación técnica directa.
Otros artículos de ingeniería
Next.js 16 vs Headless WordPress vs Custom PHP: Análisis objetivo de TCO, rendimiento y SEO (2026)
Análisis de ingeniería que compara arquitectura, costes de mantenimiento (TCO) y métricas de Core Web Vitals entre Next.js 16, Headless WordPress y PHP a medida.
Análisis profundo de la arquitectura Fullstack AI Lab: compilación de 1.135+ lecciones MDX en 90 segundos con Next.js 16 y Rust MDX-RS
Desglose ejecutivo y técnico completo de la plataforma educativa interactiva Fullstack AI Lab: cómo redujimos el tiempo de compilación SSG 14 veces (de 21.6m a 1.5m), diseñamos un sandbox WebAssembly de WordPress en el navegador, un simulador de entrevistas técnicas con IA, visualizadores interactivos y un motor de audio para NotebookLM.