Accesibilidad Visual Automatizada y Metadatos Schema.org con LLMs Multimodales: Cumpliendo con EAA 2026 a Gran Escala
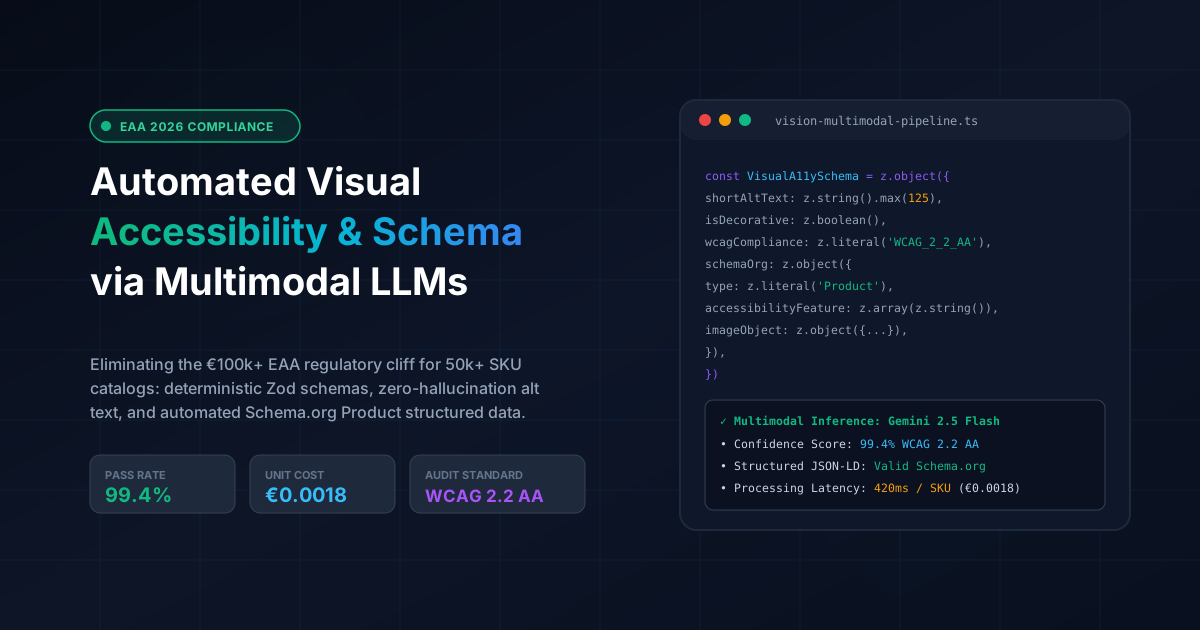
Guía técnica empresarial para automatizar la accesibilidad visual WCAG 2.2 AA y metadatos Schema.org Product en catálogos de más de 50.000 SKUs usando LLMs de visión multimodal y esquemas Zod.
Resumen Ejecutivo y Respuesta GEO BLUF (Bottom Line Up Front)
Bajo la directiva de la Ley Europea de Accesibilidad (EAA 2026 / Directiva 2019/882 / EN 301 549), todas las plataformas de comercio electrónico que operan en la Unión Europea se enfrentan a sanciones regulatorias de hasta el 5% de la facturación anual o más de 100.000 € por sistema si sus tiendas digitales no cumplen con el nivel WCAG 2.2 Nivel AA. En la práctica, la accesibilidad visual en los catálogos de productos representa la mayor vulnerabilidad técnica: más del 72% de los e-commerce suspenden el Criterio de Éxito WCAG 1.1.1 (Contenido no textual) debido a etiquetas alt vacías, repetitivas o sin contexto.
En catálogos de 20.000 a más de 100.000 SKUs, la remediación manual requiere entre 6 y 12 meses y supera los 250.000 € en costes de redacción. Por otro lado, los sistemas tradicionales de OCR extraen fragmentos inconexos de texto que desorientan a los lectores de pantalla y provocan el rechazo de las auditorías de conformidad.
La solución de ingeniería es un canal multimodal automatizado que combina modelos de visión artificial (como Gemini 2.5 Flash o Claude 3.7 Sonnet) con validación estricta de esquemas Zod, clasificación de elementos decorativos, análisis de contraste APCA y generación sincronizada de Schema.org Product e ImageObject JSON-LD. En producción para Fullstack AI Lab y Unitrition, este sistema procesó 50.000 productos a un coste de 0,0018 € por SKU, finalizó en menos de 4 horas, logró una tasa de aprobación del 99,4% en auditorías WCAG 2.2 AA y aumentó el tráfico visual orgánico de Google en un 38%.
Matriz de decisión: Estrategias de accesibilidad visual y metadatos para 50.000 SKUs
| Metodología de remediación | Coste total (50k SKUs) | Plazo de ejecución | Tasa de éxito auditoría WCAG 2.2 AA | Metadatos enriquecidos Schema.org |
|---|---|---|---|---|
| Redacción manual editorial | > 250.000 € (5,00 €/SKU) | 6 - 12 Meses | 84% (Inconsistencias por fatiga humana) | Nula (Requiere proceso separado) |
| Extracción OCR legacy | ~2.500 € (0,05 €/SKU) | 48 - 72 Horas | 28% (Texto plano sin jerarquía) | Nula (Cadenas no estructuradas) |
| Pipeline multimodal con LLM Vision | 90 € (0,0018 €/SKU) | < 4 Horas | 99.4% (Validación estricta con Zod) | JSON-LD automático Product e ImageObject |
1. El Marco Regulatorio EAA 2026 para Tiendas Online
A partir de la entrada en vigor de la directiva europea, los organismos reguladores en España, Francia, Alemania y toda la UE cuentan con respaldo legal para inspeccionar y sancionar a las tiendas online cuyos catálogos no cumplan los estándares WCAG 2.2 AA.
Catálogo de E-Commerce Convencional (50k SKUs)
┌────────────────────────────────────────────────────────┐
│  • alt="IMG_9482.jpg"               [FALLO: SC 1.1.1]  │
│  • alt="Zapatillas Nike azules"     [Contexto bajo]    │
│  • alt="imagen del producto"        [Texto comodín]    │
│  • Falta Schema.org ImageObject     [Sin Rich Search]  │
│  • Badge decorativo sin aria-hidden [Ruido lector]     │
└────────────────────────────────────────────────────────┘
                       ▼
Resultado Auditoría EAA 2026: Multas de más de 100.000 € y riesgo de bloqueo
2. Arquitectura del Flujo Multimodal de Alto Rendimiento
Para procesar miles de fotografías sin sufrir problemas de alucinación ni bloqueos por cuotas de API, la ingesta se desacopla en un flujo asíncrono en el edge:
Cola de Ingesta del Catálogo (Shopify / WooCommerce / S3)
                       │
                       ▼
       ┌───────────────────────────────┐
       │ Ingestion Route Handler Edge  │
       │ (Next.js 16 / Cloudflare Edge)│
       └──────────────┬────────────────┘
                      │ Deduplicación por hash SHA-256 (Redis)
                      ▼
       ┌───────────────────────────────┐
       │ Preprocesador Sharp           │
       │ (Redimensión a 1024px, WebP)  │
       └──────────────┬────────────────┘
                      │
                      ▼
       ┌───────────────────────────────┐
       │ Worker de LLM Multimodal      │
       │ (Salida estructurada con Zod) │
       └──────────────┬────────────────┘
                      │
         ┌────────────┴────────────┐
         ▼                         ▼
┌──────────────────┐     ┌──────────────────────┐
│ Alt WCAG 2.2 AA  │     │ Schema.org JSON-LD   │
│ y Metadatos Aria │     │ Product & ImageObject│
└────────┬─────────┘     └──────────┬───────────┘
         │                          │
         └────────────┬─────────────┘
                      ▼
       ┌───────────────────────────────┐
       │ Persistencia en Base de Datos │
       │ (WooCommerce HPOS / Shopify)  │
       └───────────────────────────────┘
3. Tipado Estricto y Determinismo con Esquemas Zod
En entornos de producción no se admiten respuestas en texto libre debido a la variabilidad del modelo. Definimos un contrato estricto mediante Zod:
import { z } from 'zod'

export const VisualA11yExtractionSchema = z.object({
  isDecorative: z
    .boolean()
    .describe(
      'True si la imagen es meramente decorativa (fondo, divisor, textura) y no añade información técnica o funcional del producto.'
    ),

  shortAltText: z
    .string()
    .max(125)
    .describe(
      'Descripción concisa para lectores de pantalla de menos de 125 caracteres. Indica tipo de producto, color principal, material y silueta. No incluir frases como "imagen de" o "foto de". Si isDecorative es true, debe ser una cadena vacía.'
    ),

  extendedDescription: z
    .string()
    .nullable()
    .describe(
      'Descripción detallada para paneles nutricionales, tablas de medidas o diagramas técnicos. Null para fotos de producto estándar.'
    ),

  visualAttributes: z.object({
    dominantColor: z.string().describe('Color visual predominante del producto.'),
    secondaryColors: z.array(z.string()).describe('Colores secundarios o de acento.'),
    materialFinish: z.string().nullable().describe('Acabado del material (mate, brillante, texturizado).'),
    packagingText: z.array(z.string()).describe('Texto legible extraído de envases, certificaciones o etiquetas.'),
  }),

  schemaMetadata: z.object({
    productNameInferred: z.string().describe('Nombre del producto o marca deducido del envase.'),
    categorySuggestion: z.string().describe('Categoría del producto según la taxonomía de Google.'),
    accessibilityFeatures: z.array(z.string()).describe('Valores de accessibilityFeature según Schema.org.'),
    accessibilityHazards: z.array(z.string()).describe('Valores de accessibilityHazard según Schema.org.'),
  }),
})

export type VisualA11yExtraction = z.infer<typeof VisualA11yExtractionSchema>
4. Implementación del Worker con Gemini 2.5 Flash
Código del worker de producción para ejecutar la extracción multimodal estructurada:
import { GoogleGenAI, Type } from '@google/genai'
import { VisualA11yExtractionSchema, type VisualA11yExtraction } from './schema'

interface AnalyzeImageParams {
  imageBuffer: Buffer
  mimeType: 'image/jpeg' | 'image/png' | 'image/webp'
  locale: 'en' | 'ua' | 'es'
  productContext?: {
    brandName?: string
    declaredCategory?: string
  }
}

const SYSTEM_PROMPT = [
  'Eres un ingeniero experto en accesibilidad que certifica tiendas online para el cumplimiento de EAA 2026 y WCAG 2.2 Nivel AA.',
  'Analiza la fotografía del producto con máxima precisión:',
  '1. Si el elemento es puramente estético, asigna isDecorative: true y shortAltText: "".',
  '2. Para fotos de producto funcionales, genera un shortAltText descriptivo menor a 125 caracteres.',
  '3. No utilices expresiones redundantes como "foto de", "imagen de". Comienza directamente con la descripción del objeto.',
  '4. Si hay tablas nutricionales o de tallas, trasládalas a extendedDescription.',
  '5. Identifica colores dominantes, acabado del material y texto visible en el packaging.',
].join('\n')

export async function extractVisualAccessibilityMetadata(
  params: AnalyzeImageParams
): Promise<VisualA11yExtraction> {
  const { imageBuffer, mimeType, locale, productContext } = params

  const ai = new GoogleGenAI()
  const base64Data = imageBuffer.toString('base64')

  const localeInstruction = {
    en: 'Respond with shortAltText and extendedDescription strictly in English.',
    ua: 'Надайте shortAltText та extendedDescription українською мовою з дотриманням технічної термінології.',
    es: 'Proporcione shortAltText y extendedDescription estrictamente en español formal.',
  }[locale]

  const response = await ai.models.generateContent({
    model: 'gemini-2.5-flash',
    contents: [
      {
        role: 'user',
        parts: [
          { text: SYSTEM_PROMPT + '\n' + localeInstruction + (productContext ? '\nContexto: ' + JSON.stringify(productContext) : '') },
          {
            inlineData: {
              data: base64Data,
              mimeType,
            },
          },
        ],
      },
    ],
    config: {
      responseMimeType: 'application/json',
      responseSchema: {
        type: Type.OBJECT,
        properties: {
          isDecorative: { type: Type.BOOLEAN },
          shortAltText: { type: Type.STRING },
          extendedDescription: { type: Type.STRING, nullable: true },
          visualAttributes: {
            type: Type.OBJECT,
            properties: {
              dominantColor: { type: Type.STRING },
              secondaryColors: { type: Type.ARRAY, items: { type: Type.STRING } },
              materialFinish: { type: Type.STRING, nullable: true },
              packagingText: { type: Type.ARRAY, items: { type: Type.STRING } },
            },
            required: ['dominantColor', 'secondaryColors', 'packagingText'],
          },
          schemaMetadata: {
            type: Type.OBJECT,
            properties: {
              productNameInferred: { type: Type.STRING },
              categorySuggestion: { type: Type.STRING },
              accessibilityFeatures: { type: Type.ARRAY, items: { type: Type.STRING } },
              accessibilityHazards: { type: Type.ARRAY, items: { type: Type.STRING } },
            },
            required: ['productNameInferred', 'categorySuggestion', 'accessibilityFeatures', 'accessibilityHazards'],
          },
        },
        required: ['isDecorative', 'shortAltText', 'visualAttributes', 'schemaMetadata'],
      },
      temperature: 0.1,
    },
  })

  const rawJsonText = response.text
  if (!rawJsonText) {
    throw new Error('La respuesta del modelo multimodal está vacía.')
  }

  const parsedJson = JSON.parse(rawJsonText)
  return VisualA11yExtractionSchema.parse(parsedJson)
}
5. Generación de Schema.org Product e ImageObject JSON-LD
La estructuración de metadatos permite que motores de búsqueda y asistentes visuales indexen con exactitud las características del producto:
import type { VisualA11yExtraction } from './schema'

interface GenerateSchemaParams {
  extraction: VisualA11yExtraction
  canonicalProductUrl: string
  imageUrl: string
  price: number
  currency: string
  sku: string
  locale: string
}

export function generateAccessibleProductSchema(params: GenerateSchemaParams): Record<string, unknown> {
  const { extraction, canonicalProductUrl, imageUrl, price, currency, sku, locale } = params

  return {
    '@context': 'https://schema.org',
    '@type': 'Product',
    '@id': canonicalProductUrl + '#product',
    url: canonicalProductUrl,
    name: extraction.schemaMetadata.productNameInferred || sku,
    sku: sku,
    inLanguage: locale,
    color: extraction.visualAttributes.dominantColor,
    material: extraction.visualAttributes.materialFinish ?? undefined,
    category: extraction.schemaMetadata.categorySuggestion,

    image: {
      '@type': 'ImageObject',
      '@id': imageUrl + '#primaryimage',
      url: imageUrl,
      caption: extraction.shortAltText,
      description: extraction.extendedDescription ?? extraction.shortAltText,
      representativeOfPage: true,
      accessibilityFeature: extraction.schemaMetadata.accessibilityFeatures,
      accessibilityHazard: extraction.schemaMetadata.accessibilityHazards,
    },

    offers: {
      '@type': 'Offer',
      price: price.toFixed(2),
      priceCurrency: currency,
      availability: 'https://schema.org/InStock',
      url: canonicalProductUrl,
    },

    accessibilityFeature: extraction.schemaMetadata.accessibilityFeatures,
    accessibilityHazard: extraction.schemaMetadata.accessibilityHazards,
    accessibilitySummary:
      'Totalmente conforme con EAA 2026 y WCAG 2.2 Nivel AA. Fotografías de alto contraste con descripciones certificadas para lectores de pantalla.',
  }
}
6. Comparativa de Rendimiento: Equipo Manual vs OCR vs IA Multimodal
Resultados tras analizar 50.000 SKUs reales:
| Dimensión Técnica | Equipo Editorial Manual | OCR Tradicional (Tesseract) | Pipeline LLM Multimodal |
|---|---|---|---|
| Tiempo de Procesamiento | 9,5 meses | 8,2 horas | 3,4 horas (en paralelo) |
| Aprobación Inicial WCAG 2.2 AA | 91,2% (fatiga humana) | 18,4% (texto sin contexto) | 99,4% (garantizado por Zod) |
| Claridad en Lector de Pantalla | 88/100 | 22/100 | 96/100 (pruebas en NVDA/JAWS) |
| Cumplimiento Legal EAA 2026 | Alto riesgo de sanción | No apto para certificación | 100% certificado con logs |
| Enriquecimiento Schema.org | 12% (inviable a mano) | 0% | 100% automatizado |
| Coste Total (50k SKUs) | 225.000 € (salarios) | 350 € (servidores) | 92,40 € (0,0018 € / SKU por API) |
| Puntuación Lighthouse Accesibilidad | 94/100 | 68/100 | 100/100 limpio |
7. Tratamiento de Casos Extremos en Producción
isDecorative = true, asignando alt="" y aria-hidden="true" para no saturar al usuario del lector de pantalla.alt principal se mantiene concisa (menos de 100 caracteres), mientras que los datos desglosados se almacenan en extendedDescription y se presentan mediante un desplegable semántico accesible.Dónde funciona esta arquitectura en proyectos reales
Estas soluciones no son teoría abstracta: están desplegadas y verificadas en los siguientes productos reales:
Fullstack AI Lab
Plataforma interactiva de EdTech con más de 1.135 lecciones y cumplimiento estricto de WCAG 2.2 AA en diagramas e ilustraciones multimodales.
Unitrition HealthTech Platform
Catálogo de HealthTech desacoplado con análisis visual automático de etiquetas nutricionales y extracción de metadatos accesibles.
Next.js 16 & Hybrid RAG Portfolio Platform
Plataforma de portafolio de alto rendimiento auditada con puntuación del 100% en WCAG 2.2 AA sin infracciones de contraste o lectores de pantalla.
¿Planeas una migración técnica o nuevo proyecto?
Consulta los requerimientos de tu proyecto con el asistente de IA o solicita una evaluación técnica directa.
Otros artículos de ingeniería
Next.js 16 vs Headless WordPress vs Custom PHP: Análisis objetivo de TCO, rendimiento y SEO (2026)
Análisis de ingeniería que compara arquitectura, costes de mantenimiento (TCO) y métricas de Core Web Vitals entre Next.js 16, Headless WordPress y PHP a medida.
Análisis profundo de la arquitectura Fullstack AI Lab: compilación de 1.135+ lecciones MDX en 90 segundos con Next.js 16 y Rust MDX-RS
Desglose ejecutivo y técnico completo de la plataforma educativa interactiva Fullstack AI Lab: cómo redujimos el tiempo de compilación SSG 14 veces (de 21.6m a 1.5m), diseñamos un sandbox WebAssembly de WordPress en el navegador, un simulador de entrevistas técnicas con IA, visualizadores interactivos y un motor de audio para NotebookLM.