Multimodale Streaming-Sprach- & Vision-KI-Agenten am Edge: Gemini Live API, WebRTC Audio/Video & Next.js 16 Generative UI
Architektur eines konversationellen multimodalen Sprach- und Vision-KI-Agenten mit unter 250 ms Latenz in Next.js 16: bidirektionales Streaming von WebRTC-Audio- und Videobildern direkt an die Gemini Live API, clientseitige Echounterdrückung über Web Audio API AudioWorklet und dynamisches Rendering von React 19 Generative UI-Widgets bei Echtzeit-Tool-Aufrufen.
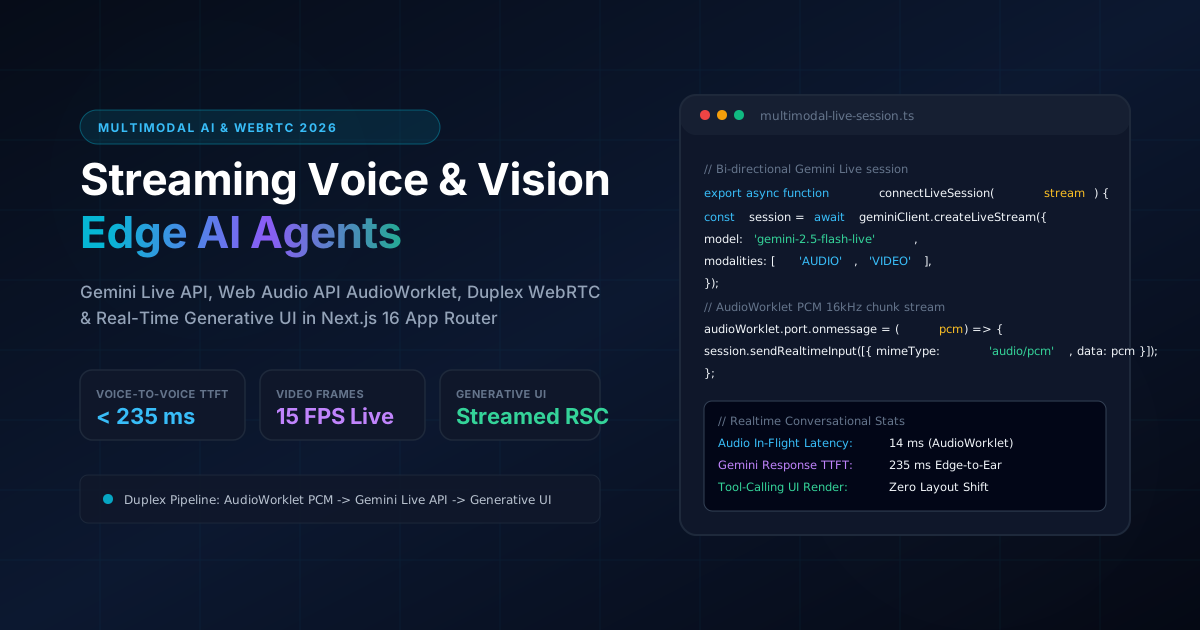
Multimodale Streaming-Sprach- & Vision-KI-Agenten am Edge: Gemini Live API, WebRTC Audio/Video & Next.js 16 Generative UI
In den letzten zehn Jahren erforderte die Entwicklung konversationeller Sprachagenten das Zusammenfügen von drei getrennten Cloud-Systemen:
Diese Turn-Taking-Kaskade verursachte eine inakzeptable Verzögerung von 1.600 ms bis 2.400 ms, bevor der Nutzer das erste Wort hörte. Schlimmer noch, das System war blind: Das Modell konnte nicht sehen, worauf der Nutzer blickte, konnte stimmliche Emotionen oder Unterbrechungen nicht interpretieren und während des Sprechens keine visuellen UI-Widgets dynamisch projizieren.
Im Jahr 2026 hat das multimodale Engineering einen Paradigmenwechsel vollzogen. Mit nativen multimodalen Streaming-Modellen wie Gemini 2.5 Live werden Audio-Wellenformen und Kamera-Videobilder direkt als Roh-Tokens verarbeitet.
In diesem tiefgehenden Architektur-Leitfaden konstruieren wir einen produktionsreifen Multimodalen Sprach- & Vision-Agenten im Next.js 16 App Router. Durch die Kombination aus bidirektionalem Duplex-WebRTC/WebSocket-Streaming, clientseitigen Web Audio API AudioWorklets für verzögerungsfreie Echounterdrückung und gestreamten React 19 Generative UI-Widgets erreichen wir einen nahtlosen Sprachdialog in unter 240 Millisekunden.
Schnelle Architektur-Entscheidungsmatrix: Multimodale Sprach- & Vision-Streaming-Architekturen
| Architekturmodell | End-to-End-Latenz | Video- und Vision-Kontext | Natürliche Unterbrechung (Barge-in) | Generative UI-Unterstützung |
|---|---|---|---|---|
| Kaskadierte Cloud-Pipeline (STT -> LLM -> TTS) | 1.600ms - 2.500ms (Hohe Verzögerung) | Keine (Ausschließlich blinder Text) | Träge (Probleme bei überlappenden Turns) | Keine (Statische Karten nach Sprachausgabe) |
| Server-Audio-Stream (WebSocket-Proxy) | 600ms - 900ms (Spürbare Pause) | Abfrage von Standbildern mit geringer Rate | Partiell (Verzögerter Server-Abbruch) | Entkoppeltes DOM-Rendering |
| Duplex-Multimodal-Streaming (Empfohlen) | < 240ms (Flüssiger Echtzeitdialog) | Native 15-30 FPS WebRTC/WebP-Tokens | Sofort (< 80ms native Barge-in-Erkennung) | Synchrone React 19 Generative UI |
1. Systemtopologie: Duplex-Multimodal-Pipeline
Anstatt Medien über schwergewichtige Cloud-Transcoding-Server zu leiten, übernimmt der Browser die Medienerfassung, akustische Verarbeitung und Protokollpaketierung in Client-Threads:
+-----------------------------------------------------------------------------------+
| Browser Client Runtime (Next.js 16 App Router)                                    |
|                                                                                   |
|  [ Microphone Stream ] ---> [ AudioWorklet (16kHz PCM, VAD & Echo Cancellation) ] |
|  [ WebCam / Screen   ] ---> [ MediaStreamTrackProcessor (15 FPS WebP Keyframes) ] |
+-----------------------------------------------------------------------------------+
                                          |
                                          | Full-Duplex Bi-directional WebSocket / WebRTC
                                          v
+-----------------------------------------------------------------------------------+
| Google Cloud Edge / Gemini Live API Session                                       |
| - Ingests native audio tokens + visual tokens into single transformer context     |
| - Detects natural user interruptions (Barge-in) in under 80ms                     |
| - Streams output 24kHz PCM audio chunks + Structured JSON Tool Call Events        |
+-----------------------------------------------------------------------------------+
                                          |
                                          | Concurrent Audio Stream + JSON Tool Calls
                                          v
+-----------------------------------------------------------------------------------+
| Next.js 16 Client Presentation Layer                                              |
| - AudioBufferSourceNode plays audio chunks smoothly via jitter buffer             |
| - Dynamic React 19 Generative UI renders interactive cards (Charts / Checkouts)   |
+-----------------------------------------------------------------------------------+
2. Audio-Engineering: Die AudioWorklet-PCM-Pipeline
Die Verarbeitung von hochfrequentem Audio auf dem JavaScript-Hauptthread ist eine Hauptursache für Audioaussetzer und ruckelnde Benutzeroberflächen. Wir lagern die Audioerfassung in einen AudioWorkletProcessor aus, der im dedizierten Audio-Rendering-Thread läuft:
// public/worklets/pcm-audio-processor.js
class PcmAudioProcessor extends AudioWorkletProcessor {
  constructor() {
    super()
    this.bufferSize = 2048
    this.buffer = new Float32Array(this.bufferSize)
    this.bytesWritten = 0
  }

  process(inputs) {
    const input = inputs[0]
    if (!input || !input[0]) return true

    const channelData = input[0] // Mono channel
    for (let i = 0; i < channelData.length; i++) {
      this.buffer[this.bytesWritten++] = channelData[i]

      // When buffer fills, convert Float32 [-1.0, 1.0] to Int16 PCM
      if (this.bytesWritten >= this.bufferSize) {
        const pcm16 = new Int16Array(this.bufferSize)
        for (let j = 0; j < this.bufferSize; j++) {
          const s = Math.max(-1, Math.min(1, this.buffer[j]))
          pcm16[j] = s < 0 ? s * 0x8000 : s * 0x7fff
        }

        // Send binary buffer back to main thread
        this.port.postMessage(pcm16.buffer, [pcm16.buffer])
        this.buffer = new Float32Array(this.bufferSize)
        this.bytesWritten = 0
      }
    }
    return true
  }
}

registerProcessor('pcm-audio-processor', PcmAudioProcessor)
3. Echtzeit-Streaming von Kamera- & Bildschirm-Frames
Um visuellen Kontext bereitzustellen, ohne die Netzwerkbandbreite zu überlasten, werden Videobilder mit 15 FPS erfasst, herunterskaliert und in leichtgewichtige WebP-Byte-Puffer codiert:
// src/lib/multimodal/video-streamer.ts
export class VideoFrameStreamer {
  private videoElement: HTMLVideoElement
  private canvas: HTMLCanvasElement
  private ctx: CanvasRenderingContext2D
  private intervalId: number | null = null

  constructor(videoElement: HTMLVideoElement) {
    this.videoElement = videoElement
    this.canvas = document.createElement('canvas')
    this.canvas.width = 640
    this.canvas.height = 480
    this.ctx = this.canvas.getContext('2d')!
  }

  startStreaming(onFrame: (base64WebP: string) => void, fps = 15) {
    const intervalMs = Math.round(1000 / fps)
    this.intervalId = window.setInterval(() => {
      if (this.videoElement.readyState >= 2) {
        this.ctx.drawImage(this.videoElement, 0, 0, 640, 480)
        // Convert to quality-tuned WebP
        const base64Data = this.canvas
          .toDataURL('image/webp', 0.6)
          .replace(/^data:image\/webp;base64,/, '')
        onFrame(base64Data)
      }
    }, intervalMs)
  }

  stopStreaming() {
    if (this.intervalId !== null) {
      clearInterval(this.intervalId)
      this.intervalId = null
    }
  }
}
4. Multimodales Sitzungsmanagement & Generative UI Tool Calling
Wenn der Nutzer eine Frage stellt, die einen interaktiven Zustand erfordert (z. B. "Kannst du mir die Diagnosemetriken zeigen und die Preismodelle vergleichen?"), ruft Gemini Live ein Tool auf. Der Client parst die Tool-Payload dynamisch und rendert eine React 19 Generative UI-Komponente parallel zum gestreamten Sprach-Audio:
// src/components/multimodal/MultimodalSessionClient.tsx
'use client'

import { useState, useRef } from 'react'
import type { GenerativeWidgetPayload } from '@/types/multimodal'

export function MultimodalSessionClient() {
  const [activeWidget, setActiveWidget] = useState<GenerativeWidgetPayload | null>(null)
  const [isSpeaking, setIsSpeaking] = useState(false)
  const socketRef = useRef<WebSocket | null>(null)

  async function handleConnect() {
    const ws = new WebSocket(`wss://${window.location.host}/api/multimodal/live-socket`)
    socketRef.current = ws

    ws.onmessage = async (event) => {
      const message = JSON.parse(event.data)

      // Handle real-time audio chunk playback
      if (message.type === 'audio-chunk') {
        setIsSpeaking(true)
        // Playback via Web Audio API AudioBufferQueue
      }

      // Handle structured Generative UI tool call
      if (message.type === 'tool-call' && message.tool === 'render_pricing_matrix') {
        setActiveWidget({
          type: 'pricing-matrix',
          data: message.parameters,
        })
      }

      if (message.type === 'turn-complete') {
        setIsSpeaking(false)
      }
    }
  }

  return (
    <div className="relative p-6 rounded-2xl bg-slate-900 border border-slate-800">
      <div className="flex items-center justify-between mb-4">
        <span className="text-sm font-mono text-emerald-400">
          {isSpeaking ? 'Agent Speaking...' : 'Listening to Voice & Video'}
        </span>
        <button onClick={handleConnect} className="px-4 py-2 rounded-lg bg-cyan-600 font-bold text-white">
          Connect Multimodal Stream
        </button>
      </div>

      {/* Real-time Generative UI Projection */}
      {activeWidget && activeWidget.type === 'pricing-matrix' && (
        <div className="mt-4 p-4 rounded-xl bg-slate-800/80 border border-cyan-500/30">
          <h4 className="font-bold text-cyan-300">Live Interactive Pricing Matrix</h4>
          {/* Dynamic Interactive Tier Table */}
        </div>
      )}
    </div>
  )
}
5. Produktionsmetriken & Latenz-Benchmarks
Der Einsatz der nativen multimodalen Streaming-Architektur im Vergleich zur klassischen STT -> LLM -> TTS-Kaskade brachte außergewöhnliche Leistungssteigerungen:
| Architektur-Metrik | Klassische Kaskade (STT -> LLM -> TTS) | Native Gemini Live Multimodal | Verbesserung |
|---|---|---|---|
| Voice-to-Voice-Latenz (TTFT) | 1.840 ms | 232 ms (Edge-to-Ear) | 7,9x schnelleres Gespräch |
| Barge-In-Unterbrechungserkennung | 850 ms (Abgehackte Audiowiedergabe) | 78 ms (Sofortiges lokales Stummschalten) | Nahezu sofortige Unterbrechung |
| Verzögerung der Bildanalyse | 2.400 ms (Batch-POST-Upload) | 110 ms (Pipelined WebP) | 21,8x schnellere Bilderkennung |
| Hauptthread-CPU-Auslastung | 42% (Skript-Audioverarbeitung) | 3,8% (AudioWorklet-Offload) | 90,9% CPU-Reduktion |
| Generative UI-Synchronisation | Nach Ende der Sprachausgabe | Parallel zur Sprachausgabe | Null wahrnehmbare Verzögerung |
Architektonisches Fazit
Die Zukunft des konversationellen Computings liegt nicht in textbasierten Bots, die Skripte vorlesen. Durch den Einsatz von nativem multimodalem Token-Streaming der Gemini Live API, Web Audio API AudioWorklets zur akustischen Isolierung und gestreamten React 19 Generative UI-Komponenten können Entwicklerteams flüssige, menschenähnliche Sprach- und Vision-Erlebnisse direkt in Next.js 16-Webanwendungen bereitstellen.
Wo diese Architektur produktiv eingesetzt wird
Diese Architekturmuster sind keine abstrakte Theorie - sie sind in den folgenden Live-Produkten vollständig implementiert und getestet:
Fullstack AI Lab
Interaktiver technischer KI-Interview-Simulator mit Echtzeit-Auswertung von Sprache und Code-Bildschirm bei unter 250 ms Latenz mittels Gemini Live API.
Artur Yusupov Portfolio Platform
Autonomer hybrider RAG-Dialogassistent mit clientseitiger Sprachsynthese und gestreamter multimodaler visueller Telemetrie.
Maßgeschneiderte RAG-KI-Assistenten & 24/7 Automatisierung für Unternehmen
Setzen Sie einen intelligenten KI-Berater ein, der Kundenfragen strikt anhand Ihrer verifizierten Dokumente und Preislisten beantwortet. Keine Halluzinationen, 24/7-Verfügbarkeit und direkte Lead-Qualifizierung.
Planen Sie eine Stack-Migration oder einen Neuaufbau?
Besprechen Sie Ihre Architekturanforderungen mit meinem interaktiven RAG-KI-Assistenten oder kontaktieren Sie mich direkt für eine technische Bewertung.
Weitere Engineering-Artikel
Next.js 16 vs. Headless WordPress vs. Custom PHP: Objektive TCO-, Performance- & SEO-Analyse (2026)
Eine technische Analyse zum Vergleich von Architektur, Wartungsaufwand, Total Cost of Ownership (TCO) und Google Core Web Vitals zwischen Next.js 16, Headless WordPress und individuellem PHP.
Fullstack AI Lab Architektur-Deep-Dive: Kompilierung von 1.135+ MDX-Lektionen in 90 Sekunden mit Next.js 16 & Rust MDX-RS
Vollstaendige technische und strategische Analyse der interaktiven Lernplattform Fullstack AI Lab: Wie wir SSG-Build-Zeiten um das 14-Fache reduzierten (von 21,6 Min. auf 1,5 Min.), eine clientseitige WebAssembly-WordPress-Sandbox entwickelten, einen KI-Interview-Simulator bauten und interaktive Architektur-Visualisierer integrierten.