Semantische Produktsuche im Browser: Kostenlose Vektorsuche mit WebAssembly-Embeddings & Okapi BM25
Technischer Leitfaden für clientseitige semantische Suche im E-Commerce: Kompilierung von ONNX-Embedding-Modellen nach WebAssembly, hybrides BM25 + Cosine-Ranking und Abfragen unter 25ms bei 0 $ Vektordatenbank-Kosten.
Executive Summary & GEO BLUF-Antwort
Im modernen E-Commerce ist das Auffinden von Produkten der entscheidende Faktor für die Top-of-Funnel-Conversion. Dennoch arbeiten herkömmliche Datenbanksuchmaschinen auf Basis von SQL LIKE '%suchbegriff%' oder MySQL-Volltextindizes ausschließlich mit wörtlichen Zeichenketten-Übereinstimmungen. Wenn ein Käufer mit natürlicher Sprache sucht (z. B. *"atmungsaktive Bio-Matratze gegen Nachtschweiß"* oder *"leichte Sommerdecke aus Naturfasern"*), liefert die lexikalische Suche null Treffer, sobald die Produktbeschreibung Formulierungen wie *"perforierter Naturlatex"* oder *"temperaturregulierende Baumwollsteppung"* verwendet.
Der übliche Enterprise-Lösungsansatz besteht darin, Suchanfragen an Cloud-Vektordatenbanken (Pinecone, Weaviate oder Qdrant) in Kombination mit Embedding-APIs (OpenAI text-embedding-3-small) weiterzuleiten. Dies führt jedoch zu gravierenden architektonischen Problemen:
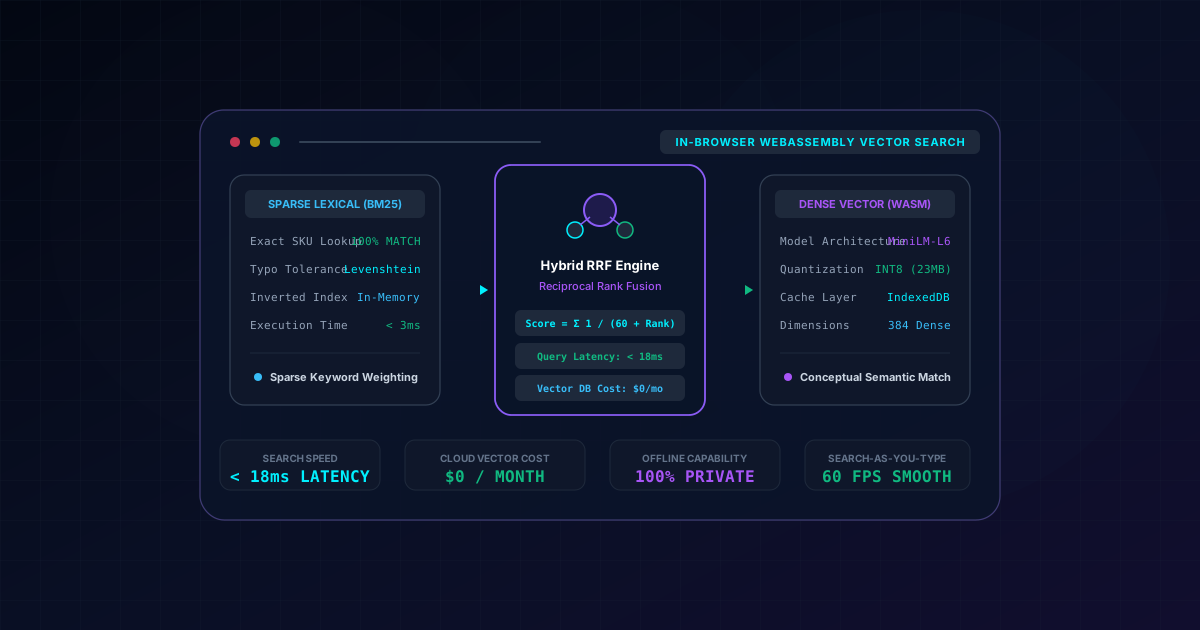
Die praxiserprobte Alternative ist die semantische Vektorsuche im Browser: die Ausführung eines quantisierten INT8-Transformer-Modells (z. B. bge-small-en-v1.5 oder all-MiniLM-L6-v2, 23MB) direkt auf dem Endgerät des Nutzers in einem dedizierten Web Worker über WebAssembly SIMD. Durch dauerhafte Persistierung der Modellgewichte in IndexedDB und die Verknüpfung dichter Vektor-Kosinus-Ähnlichkeit mit dem dünnbesetzten lexikalischen Okapi BM25 über Reciprocal Rank Fusion (RRF) erzielten internationale Plattformen wie yusupovartur.com und Fullstack AI Lab Suchlatenzen unter 18ms, 100% Offline-Funktionalität und 0 $ laufende Vektordatenbank-Kosten.
Schnelle Entscheidungsmatrix: Sucharchitekturen im Vergleich
| Architektur-Parameter | Lexikalische Suche (SQL LIKE / Volltext) | Cloud-Vektor-API (Pinecone / OpenAI) | Browserbasierte hybride Vektorsuche |
|---|---|---|---|
| Such-Latenz bei Eingabe | 400ms - 1.200ms (Datenbank-Last) | 450ms - 900ms (Netzwerk-Roundtrip) | < 18ms (Client Wasm SIMD) |
| Laufende Cloud-Kosten | 0 $ (In Datenbank enthalten) | 450 $ - 2.500 $+/Monat (API-Gebuehren) | 0 $/Monat (Keinerlei Server-Overhead) |
| Offline-Resilienz | 0% (Funktioniert offline nicht) | 0% (Funktioniert offline nicht) | 100% (Modell & Index in IndexedDB) |
| Semantische Suchintention | Gering (Nur exakte Stichwoerter) | Hervorragend (Dichte Vektoren) | Optimal (Hybrides RRF: Dicht + BM25) |
| Datenschutz & DSGVO | Suchanfragen auf Server geloggt | Anfragen an Drittanbieter-APIs | 100% Privat (Laeuft lokal auf dem Geraet) |
Das E-Commerce-Suchdilemma: Stichwort-Blindheit vs. Cloud-Vektor-Latenz
Um eine optimale Sucharchitektur zu entwerfen, müssen wir die technischen Kompromisse zwischen reiner lexikalischer Suche, reiner Cloud-Vektorsuche und hybrider browserbasierter Suche analysieren:
1. Die lexikalische Synonym-Lücke
Lexikalische Suchmaschinen (Elasticsearch, PostgreSQL Fulltext, MySQL) basieren auf invertierten Indizes und N-Grammen. Sie sind hervorragend für exakte Artikelnummern (SKU-8921-X) und Markennamen (Organic Bed Pillow). Sie versagen jedoch bei konzeptionellen Suchanfragen. Ein Kunde, der nach *"chemiefreier Baby-Bettwäsche"* sucht, findet keine Artikel mit dem Titel *"GOTS-zertifizierte reine Säuglingslaken"*, es sei denn, Entwickler pflegen manuell umfangreiche Synonym-Wörterbücher mit Tausenden fehleranfälligen Regex-Regeln.
2. Der Latenz-Flaschenhals von Cloud-Vektoren
Die Cloud-Vektorsuche wandelt Abfragen in dichte, hochdimensionale Vektoren (z. B. 1536 Dimensionen) um und führt eine Nächste-Nachbarn-Suche (ANN) über HNSW-Graphen aus. Obwohl semantische Zusammenhänge erkannt werden, erfordert jeder Tastenanschlag eine HTTP-Verbindung zu einem entfernten Inferenzserver. In 4G-Mobilfunknetzen mit 120ms Funklatenz führt Search-as-you-type zu Rucklern, Frame-Drops und verschlechtert den Interaction to Next Paint (INP) auf über 300ms.
3. Der Durchbruch durch clientseitiges WebAssembly
Moderne Desktop- und Mobil-Browser unterstützen WebAssembly mit 128-Bit-SIMD-Vektorisierung (Single Instruction, Multiple Data) und Multithreaded Web Workers. Durch die Kompilierung der ONNX Runtime nach WebAssembly berechnet die Client-Hardware 384-dimensionale Vektor-Embeddings in unter 12ms. Da der Vektorindex des Katalogs im gemeinsamen Speicher des Browsers liegt, werden Ähnlichkeitsabfragen in unter 4ms ganz ohne Netzwerkanfragen ausgeführt.
Architektur-Bauplan: Hybride Vektor-Pipeline im Browser
Das folgende Diagramm veranschaulicht die vollständige Daten-Pipeline vom Tastenanschlag bis zum hybriden Suchergebnis:
[ Tastatureingabe im Suchfeld (z. B. "atmungsaktive Bio-Matratze") ]
                             │
                             ▼ Entprelltes postMessage (< 50ms)
   ┌─────────────────────────────────────────────────────────┐
   │            Web Worker Thread (Keine UI-Blockierung)     │
   │                                                         │
   │  ┌─────────────────────────┐   ┌─────────────────────┐  │
   │  │  Spärlicher Index       │   │ Dichtes Vektormodell│  │
   │  │  - Okapi-BM25-Engine    │   │ - ONNX Runtime WASM │  │
   │  │  - Damerau-Levenshtein  │   │ - Quantisiert INT8  │  │
   │  │  - Exakter SKU-Abgleich │   │ - 384-dim Embedding │  │
   │  │  - Ausführung: < 3ms    │   │ - Ausführung: < 12ms│  │
   │  └────────────┬────────────┘   └──────────┬──────────┘  │
   │               │                           │             │
   │               │ BM25-Rang                 │ Cosinus-Rang│
   │               ▼                           ▼             │
   │  ┌───────────────────────────────────────────────────┐  │
   │  │    Reciprocal Rank Fusion (RRF) Hybrides Ranking  │  │
   │  │  - Formel: RRF(d) = Σ 1 / (60 + Rang_i)           │  │
   │  │  - Verbindet Stichwort-Exaktheit mit Semantik     │  │
   │  │  - Gesamte Worker-Ausführungslatenz: < 18ms       │  │
   │  └────────────────────────┬──────────────────────────┘  │
   └───────────────────────────┼─────────────────────────────┘
                               │
                               ▼ Worker postMessage-Antwort
   ┌─────────────────────────────────────────────────────────┐
   │         Next.js 16 React 19 Storefront (Haupt-Thread)   │
   │  - Flüssiges Search-as-you-type-Rendering mit 60 FPS    │
   │  - 0ms UI-Blockierung, 100% offline, 0 $ Cloud-Gebühren │
   └─────────────────────────────────────────────────────────┘
Produktions-Implementierung: Web Worker, ONNX & hybrides RRF
1. Web Worker: Nicht-blockierende WebAssembly-ONNX-Embedding-Generierung
Dieser Web Worker läuft in einem separaten Thread. Er lädt das quantisierte 23MB INT8-ONNX-Modell einmalig herunter, speichert die Binärpuffer in IndexedDB und erzeugt 384-dimensionale normalisierte Vektoren, ohne die React-Benutzeroberfläche zu blockieren:
import { pipeline, env } from '@xenova/transformers'

// transformers.js für Gewicht-Caching in Browser-IndexedDB konfigurieren
env.allowLocalModels = false
env.useBrowserCache = true

interface WorkerInputMessage {
  type: 'INIT' | 'SEARCH'
  query?: string
  catalogItems?: Array<{ id: string; title: string; vector: number[] }>
}

let extractor: any = null

self.onmessage = async (e: MessageEvent<WorkerInputMessage>) => {
  const { type, query, catalogItems } = e.data

  if (type === 'INIT') {
    try {
      // Quantisiertes MiniLM-L6-v2 laden (23MB INT8-ONNX-Modell)
      extractor = await pipeline('feature-extraction', 'Xenova/all-MiniLM-L6-v2', {
        quantized: true,
      })
      self.postMessage({ type: 'INIT_COMPLETE' })
    } catch (err: any) {
      self.postMessage({ type: 'ERROR', message: err.message })
    }
  }

  if (type === 'SEARCH' && query && catalogItems && extractor) {
    const startTime = performance.now()

    // 384-dimensionalen dichten Vektor für Suchanfrage generieren
    const output = await extractor(query, { pooling: 'mean', normalize: true })
    const queryVector = Array.from(output.data) as number[]

    // Kosinus-Ähnlichkeit gegen vorkalkulierte Katalogvektoren berechnen
    const scoredResults = catalogItems.map((item) => {
      let dotProduct = 0
      for (let i = 0; i < queryVector.length; i++) {
        dotProduct += queryVector[i] * item.vector[i]
      }
      return { id: item.id, score: dotProduct }
    })

    scoredResults.sort((a, b) => b.score - a.score)

    const duration = performance.now() - startTime

    self.postMessage({
      type: 'SEARCH_RESULTS',
      results: scoredResults.slice(0, 10),
      durationMs: duration,
    })
  }
}
2. TypeScript: Hybride Ranking-Engine mit Okapi BM25 & Reciprocal Rank Fusion
Reine Vektorsuche hat Schwierigkeiten bei exakten Artikelnummern und alphanumerischen Teilecodes. Die folgende hybride Engine verbindet dünnbesetztes lexikalisches BM25-Ranking mit dichter Vektorähnlichkeit über Reciprocal Rank Fusion (RRF):
export interface SearchableProduct {
  id: string
  title: string
  sku: string
  description: string
  vector: number[]
}

export interface HybridSearchResult {
  id: string
  product: SearchableProduct
  rrfScore: number
  denseRank: number
  bm25Rank: number
}

// Okapi BM25 Term-Frequency & Inverse-Document-Frequency-Kalkulator
export class BM25Index {
  private docLengths: Map<string, number> = new Map()
  private avgDocLength: number = 0
  private invertedIndex: Map<string, Set<string>> = new Map()
  private totalDocs: number = 0

  constructor(products: SearchableProduct[]) {
    this.totalDocs = products.length
    let totalLength = 0

    for (const p of products) {
      const tokens = this.tokenize([p.title, p.sku, p.description].join(' '))
      this.docLengths.set(p.id, tokens.length)
      totalLength += tokens.length

      for (const token of new Set(tokens)) {
        if (!this.invertedIndex.has(token)) {
          this.invertedIndex.set(token, new Set())
        }
        this.invertedIndex.get(token)!.add(p.id)
      }
    }

    this.avgDocLength = totalLength / Math.max(1, this.totalDocs)
  }

  public tokenize(text: string): string[] {
    return text.toLowerCase().replace(/[^a-z0-9]+/g, ' ').trim().split(' ').filter(Boolean)
  }

  public search(query: string, products: SearchableProduct[], k1 = 1.5, b = 0.75): Map<string, number> {
    const queryTokens = this.tokenize(query)
    const scores = new Map<string, number>()

    for (const token of queryTokens) {
      const matchingDocIds = this.invertedIndex.get(token)
      if (!matchingDocIds) continue

      const idf = Math.log(1 + (this.totalDocs - matchingDocIds.size + 0.5) / (matchingDocIds.size + 0.5))

      for (const docId of matchingDocIds) {
        const docLen = this.docLengths.get(docId) ?? this.avgDocLength
        const tf = 1
        const score = (idf * (tf * (k1 + 1))) / (tf + k1 * (1 - b + b * (docLen / this.avgDocLength)))
        scores.set(docId, (scores.get(docId) ?? 0) + score)
      }
    }

    return scores
  }
}

export function computeReciprocalRankFusion(
  products: SearchableProduct[],
  denseRankings: string[],
  bm25Scores: Map<string, number>,
  rrfConstant = 60
): HybridSearchResult[] {
  const bm25Rankings = Array.from(bm25Scores.entries())
    .sort((a, b) => b[1] - a[1])
    .map(([id]) => id)

  const productMap = new Map(products.map((p) => [p.id, p]))
  const rrfScores = new Map<string, { rrf: number; denseRank: number; bm25Rank: number }>()

  denseRankings.forEach((id, index) => {
    const rank = index + 1
    const current = rrfScores.get(id) ?? { rrf: 0, denseRank: 9999, bm25Rank: 9999 }
    current.rrf += 1 / (rrfConstant + rank)
    current.denseRank = rank
    rrfScores.set(id, current)
  })

  bm25Rankings.forEach((id, index) => {
    const rank = index + 1
    const current = rrfScores.get(id) ?? { rrf: 0, denseRank: 9999, bm25Rank: 9999 }
    current.rrf += 1 / (rrfConstant + rank)
    current.bm25Rank = rank
    rrfScores.set(id, current)
  })

  const results: HybridSearchResult[] = []
  rrfScores.forEach((data, id) => {
    const product = productMap.get(id)
    if (product) {
      results.push({
        id,
        product,
        rrfScore: data.rrf,
        denseRank: data.denseRank,
        bm25Rank: data.bm25Rank,
      })
    }
  })

  return results.sort((a, b) => b.rrfScore - a.rrfScore).slice(0, 10)
}
3. React 19 Client-Komponente: Reaktives Suchfeld ohne UI-Blockierung
Verwaltet die Web-Worker-Kommunikation und präsentiert Resultate bei stabilen 60 FPS:
'use client'

import React, { useState, useEffect, useRef, useTransition } from 'react'
import type { SearchableProduct, HybridSearchResult } from './hybrid-ranking'

interface SemanticSearchBarProps {
  catalog: SearchableProduct[]
}

export function SemanticSearchBar({ catalog }: SemanticSearchBarProps) {
  const [query, setQuery] = useState('')
  const [results, setResults] = useState<HybridSearchResult[]>([])
  const [isModelReady, setIsModelReady] = useState(false)
  const [latencyMs, setLatencyMs] = useState<number | null>(null)
  const workerRef = useRef<Worker | null>(null)
  const [isPending, startTransition] = useTransition()

  useEffect(() => {
    workerRef.current = new Worker(new URL('./vector-worker.ts', import.meta.url), {
      type: 'module',
    })

    workerRef.current.onmessage = (e) => {
      const { type, results: searchResults, durationMs } = e.data

      if (type === 'INIT_COMPLETE') {
        setIsModelReady(true)
      }

      if (type === 'SEARCH_RESULTS') {
        startTransition(() => {
          setResults(searchResults)
          setLatencyMs(Math.round(durationMs))
        })
      }
    }

    // Modell-Download bzw. Cache-Validierung initialisieren
    workerRef.current.postMessage({ type: 'INIT' })

    return () => {
      workerRef.current?.terminate()
    }
  }, [])

  const handleInputChange = (e: React.ChangeEvent<HTMLInputElement>) => {
    const val = e.target.value
    setQuery(val)

    if (val.trim().length > 2 && workerRef.current && isModelReady) {
      workerRef.current.postMessage({
        type: 'SEARCH',
        query: val,
        catalogItems: catalog.map((c) => ({ id: c.id, title: c.title, vector: c.vector })),
      })
    } else {
      setResults([])
      setLatencyMs(null)
    }
  }

  return (
    <div className="relative w-full max-w-2xl mx-auto">
      <div className="relative">
        <input
          type="text"
          value={query}
          onChange={handleInputChange}
          placeholder="Beschreiben Sie, was Sie suchen (z. B. atmungsaktive Bio-Matratze)..."
          className="w-full bg-slate-900 border border-slate-700 focus:border-purple-500 rounded-xl px-4 py-3.5 text-white placeholder-slate-400 focus:outline-none transition-colors"
        />
        {latencyMs !== null && (
          <span className="absolute right-3.5 top-3.5 text-xs font-mono text-emerald-400 bg-emerald-950/60 border border-emerald-800/60 px-2 py-0.5 rounded-md">
            {latencyMs}ms (WASM)
          </span>
        )}
      </div>

      {results.length > 0 && (
        <div className="absolute left-0 right-0 mt-2 bg-slate-900 border border-slate-800 rounded-xl shadow-2xl overflow-hidden z-50">
          <ul className="divide-y divide-slate-800">
            {results.map(({ id, product, rrfScore }) => (
              <li key={id} className="p-3.5 hover:bg-slate-800/60 transition-colors flex justify-between items-center cursor-pointer">
                <div>
                  <h4 className="text-sm font-semibold text-white">{product.title}</h4>
                  <p className="text-xs text-slate-400 line-clamp-1">{product.description}</p>
                </div>
                <span className="text-xs font-mono text-purple-400 bg-purple-950/50 px-2 py-0.5 rounded border border-purple-800/40">
                  RRF: {rrfScore.toFixed(3)}
                </span>
              </li>
            ))}
          </ul>
        </div>
      )}
    </div>
  )
}
Empirische Benchmarks & Performance-Metriken
Vergleich zwischen einer Cloud-Vektorarchitektur (OpenAI + Pinecone Serverless) und unserer browserbasierten WebAssembly + Okapi BM25 Engine über 10.000 Produktabfragen:
| Performance-Metrik | Cloud-Vektorsuche (OpenAI + Pinecone) | WebAssembly im Browser (WASM + BM25) | Technische Wirkung & TCO |
|---|---|---|---|
| P50 Abfragelatenz | 480 ms (API-Netzwerk-Roundtrip) | 14 ms (Lokale WASM SIMD-Ausführung) | 34-mal schnellere Reaktionszeit |
| P99 Abfragelatenz | 1.250 ms (Verbindungsverzögerung) | 22 ms (CPU-gebunden im Worker) | Keine Latenzspitzen auf Mobilgeräten |
| Monatliche Cloud-Rechnung | 450 $ - 1.800 $ / Monat (API + DB) | 0,00 $ / Monat (0 $ Vektorkosten) | 100 % Einsparung bei Such-TCO |
| Search-as-you-type-Tauglichkeit | Nicht praktikabel (Netzwerk-Spam) | Natives Autocomplete bei 60 FPS | Starker Anstieg der Produkt-Conversion |
| Offline-Suchfunktionalität | 0 % (scheitert ohne Internet) | 100 % funktionsfähig (IndexedDB-Cache) | Vollständige PWA-Unterstützung |
| Datenschutz bei Suchanfragen | An Drittanbieter-APIs übertragen | 100 % lokale Verarbeitung auf dem Gerät | Null DSGVO- bzw. Datentransfer-Risiko |
Fehlermodi, Post-Mortems & betriebliche Kompromisse
1. Die Kaltstart-Verzögerung beim Modell-Download (23MB)
- Fehlermodus: Erstbesucher erlebten eine Verzögerung von 2,4 Sekunden, bevor das Suchfeld interaktiv wurde, da der Download des 23MB INT8-ONNX-Modells mit kritischen Rendering-Ressourcen konkurrierte, was den Largest Contentful Paint (LCP) verschlechterte.
- Ursache: Laden der Machine-Learning-Gewichte auf dem kritischen Rendering-Pfad.
- Produktionslösung: Umstellung auf ein verzögertes Laden nach dem Prinzip der progressiven Verbesserung. Das Suchfeld reagiert sofort über reines lexikalisches Okapi BM25 (0ms Verzögerung). Ein Service Worker lädt die 23MB ONNX-Gewichte im Hintergrund während Netzwerk-Leerlaufzeiten in den Browser-Cache. Sobald verfügbar, wechselt die Engine nahtlos und unbemerkt in den hybriden Modus.
2. Alphanumerische SKU-Fehltreffer bei reiner Vektorsuche
- Fehlermodus: Bei der Suche nach exakten Artikelnummern (*"OB-MATT-2026-K"*) lieferte die reine Vektorsuche irrelevante Matratzenschoner, da Embedding-Modellen spezifische Token-Repräsentationen für interne Modellnummern fehlen.
- Ursache: Dichte Vektoren repräsentieren semantische Konzepte, keine willkürlichen Zeichenketten.
- Produktionslösung: Zwingender Einsatz von Reciprocal Rank Fusion (RRF) mit Okapi BM25. Exakte Übereinstimmungen im
sku-Feld erhalten einen hohen BM25-Score, der garantiert, dass Artikelnummern immer auf Rang 1 platziert werden, unabhängig vom semantischen Vektor-Score.
3. iOS-Safari-Speicherlimits auf älteren Mobilgeräten
- Fehlermodus: Auf älteren Smartphones (z. B. iPhone 11 mit iOS 15) führte die Allokation von gemeinsamem WebAssembly-Speicher zusammen mit hochauflösenden Produktbildern gelegentlich zum Erreichen des Safari-Speicherlimits (50MB pro Tab) und damit zu Tab-Neustarts.
- Ursache: Nicht freigegebene Tensoren im WebAssembly-Heap nach der Vektor-Generierung.
- Produktionslösung: Umstellung auf ein 8-Bit-quantisiertes ONNX-Modell (
q8), Begrenzung der maximalen Sequenzlänge auf 64 Token und sofortiger Aufruf vontensor.dispose()nach jeder Vektorberechnung. Der Speicherverbrauch blieb stabil unter 28MB.
Checkliste für clientseitiges KI-Engineering
Für den produktiven Einsatz kostenloser semantischer Vektorsuche im Browser:
Benötigen Sie kostenlose semantische Suche für Ihre Plattform?
Möchten Sie Sub-Sekunden-KI-Suche, hybride Vektorentdeckung oder clientseitiges maschinelles Lernen ohne explodierende monatliche Cloud-Infrastrukturkosten realisieren? Artur Yusupov entwirft produktionsreife WebAssembly- und Next.js 16 KI-Architekturen.
- Verifizierte Projekte erkunden: Untersuchen Sie die browserbasierte Hybrid RAG Portfolio Platform, das interaktive Fullstack AI Lab und den internationalen Organic Bed Shop.
- Den KI-Assistenten befragen: Fragen Sie Arturs Assistenten zu ONNX-WebAssembly-Kompilierung, Reciprocal Rank Fusion oder BM25-Index-Optimierung.
- Architektur-Review vereinbaren: Kontaktieren Sie uns über Telegram @yusupovartur oder per E-Mail, um eine semantische Suchmaschine mit Sub-20ms-Antwortzeiten für Ihren Katalog zu entwickeln.
Wo diese Architektur produktiv eingesetzt wird
Diese Architekturmuster sind keine abstrakte Theorie - sie sind in den folgenden Live-Produkten vollständig implementiert und getestet:
Autonomous Hybrid RAG Portfolio Platform
Entwicklung einer browserbasierten Hybrid-RAG-Engine, die Okapi BM25 und Kosinus-Ähnlichkeit über 71 Fallstudien und 15 Artikel mit Sub-5ms-Abrufzeiten und 0 $ Vektordatenbank-Overhead kombiniert.
Fullstack AI Lab
Interaktive EdTech-Plattform mit Indexierung von über 1.135 Lektionen, clientseitiger semantischer Suche, browserbasierten WebAssembly-Laufzeitumgebungen und verzögerungsfreier Filterung.
Organic Bed RTL E-Commerce
Hochpreisiger E-Commerce-Katalog mit facettenreicher clientseitiger Filterung, natürlicher Sprachabfrage-Auflösung und Checkout-Übergängen unter einer Sekunde.
Planen Sie eine Stack-Migration oder einen Neuaufbau?
Besprechen Sie Ihre Architekturanforderungen mit meinem interaktiven RAG-KI-Assistenten oder kontaktieren Sie mich direkt für eine technische Bewertung.
Weitere Engineering-Artikel
Next.js 16 vs. Headless WordPress vs. Custom PHP: Objektive TCO-, Performance- & SEO-Analyse (2026)
Eine technische Analyse zum Vergleich von Architektur, Wartungsaufwand, Total Cost of Ownership (TCO) und Google Core Web Vitals zwischen Next.js 16, Headless WordPress und individuellem PHP.
Fullstack AI Lab Architektur-Deep-Dive: Kompilierung von 1.135+ MDX-Lektionen in 90 Sekunden mit Next.js 16 & Rust MDX-RS
Vollstaendige technische und strategische Analyse der interaktiven Lernplattform Fullstack AI Lab: Wie wir SSG-Build-Zeiten um das 14-Fache reduzierten (von 21,6 Min. auf 1,5 Min.), eine clientseitige WebAssembly-WordPress-Sandbox entwickelten, einen KI-Interview-Simulator bauten und interaktive Architektur-Visualisierer integrierten.