Local-First In-Browser-LLMs via WebGPU: Serverlose datenschutzkonforme Inferenz in modernen Web-Apps
Ein architektonischer Deep-Dive zur Ausfuehrung quantisierter Large Language Models mit 1B-3B Parametern (Llama 3.2, Gemma 2, SmolLM2) direkt im Browser via WebGPU, Transformers.js v3 und ONNX Runtime Web: Null Hosting-Kosten, 100 % Offline-Faehigkeit, kein Datenabfluss und Sub-Sekunden-Token-Streaming.
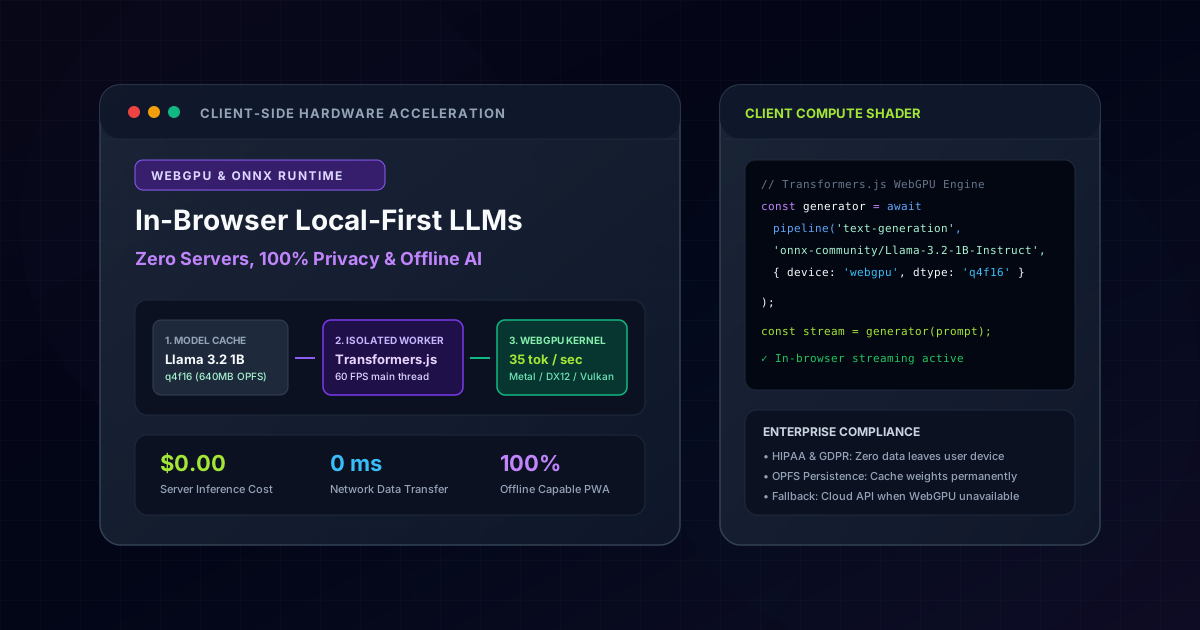
1. Der Paradigmenwechsel: Warum Local-First-KI entscheidend ist
In den vergangenen drei Jahren war die zentralisierte Cloud-Inferenz das Standardmuster im KI-Engineering: Der Client sendet sensible Benutzer-Prompts ueber HTTPS an eine externe API (OpenAI, Anthropic oder Cloud-GPU-Cluster), wartet auf den Netzwerk-Roundtrip und streamt Tokens zurueck.
Im Jahr 2026 beschleunigen drei zentrale Kraefte den Uebergang zu Local-First In-Browser-KI:
KI-Architektur-Entscheidungsmatrix: Cloud-APIs vs. In-Browser-WebGPU
| Architektur-Dimension | Zentralisierte Cloud-APIs (OpenAI / Gemini) | In-Browser-WebGPU (Local-First) |
|---|---|---|
| Server-Inferenzkosten | $0.002 - $0.015 pro Anfrage (Lineare Skalierung) | $0.00 (Keine Cloud-GPU-Infrastrukturkosten) |
| Datenschutz | Uebertragung an Drittserver (DSGVO/HIPAA-Risiken) | 100% Clientseitiger Datenschutz (Keine Netzausleitung) |
| Offline-Verfuegbarkeit | Totalausfall bei Netzwerkunterbrechung | 100% Offline-funktionsfaehig als PWA |
| Generierungsdurchsatz | Begrenzt durch Netzwerk-TTFB | 28 - 45 Tokens/s (Client-Hardware-Beschleunigung) |
| Initialer Download | Kein Modelldownload (Sofortiger Start) | 600MB - 750MB (Einmalig gecachter Browser-Download) |
2. WebGPU vs. WebGL: Der technische Quantensprung
Fruehere Browser-Machine-Learning-Frameworks basierten auf WebGL, was Entwickler dazu zwang, allgemeine Matrixoperationen als 2D-Pixel-Rendering-Shader zu tarnen.
WebGL (Legacy ML Hack)          vs          WebGPU (Modern Compute Native)
┌─────────────────────────┐                 ┌─────────────────────────┐
│ Fragment Shaders        │                 │ Pure Compute Shaders    │
│ Textures as Arrays      │                 │ Direct Memory Buffers   │
│ CPU-GPU sync overhead   │                 │ Async Command Encoders  │
│ Max 8-12 tokens/sec     │                 │ 35-50+ tokens/sec (f16) │
└─────────────────────────┘                 └─────────────────────────┘
WebGPU fuehrt native Compute Shader ein, die in WGSL (WebGPU Shading Language) geschrieben sind, unterstuetzt vollstaendig 16-Bit-Gleitkomma-Berechnungen (f16) und bietet speicherabgebildete Puffer ohne Overhead, die direkt an die Hardware-Ausfuehrung von Apple Metal, DirectX 12 und Vulkan angebunden sind.
3. Laden quantisierter Modelle mit Transformers.js v3
Dank Fortschritten bei der Quantisierung (AWQ und GGUF/ONNX) koennen modernste kleine Sprachmodelle wie Meta Llama 3.2 1B und HuggingFace SmolLM2 ohne spuerbaren Verlust an Argumentationsfaehigkeit auf 600 MB - 800 MB komprimiert werden.
// src/lib/ai/local-llm-engine.ts
import { pipeline, env } from '@huggingface/transformers';

// WebGPU-Backend und lokale Gewichtungs-Persistenz konfigurieren
env.backends.onnx.wasm.proxy = true;

export interface GenerationProgress {
  status: 'loading' | 'ready' | 'generating';
  progress?: number;
  tokensPerSec?: number;
}

export async function initializeLocalLLM(onProgress?: (p: GenerationProgress) => void) {
  // Pruefen, ob der Browser WebGPU unterstuetzt
  if (!navigator.gpu) {
    throw new Error('WebGPU is not supported in this browser. Fallback to Cloud API.');
  }

  onProgress?.({ status: 'loading', progress: 0 });

  // 4-Bit-quantisiertes Llama 3.2 1B Instruct laden
  const generator = await pipeline(
    'text-generation',
    'onnx-community/Llama-3.2-1B-Instruct',
    {
      device: 'webgpu',
      dtype: 'q4f16', // 4-Bit-Gewichte mit 16-Bit-Float-Aktivierungsmathematik
      progress_callback: (info: any) => {
        if (info.status === 'progress') {
          onProgress?.({ status: 'loading', progress: Math.round(info.progress || 0) });
        }
      },
    }
  );

  onProgress?.({ status: 'ready' });
  return generator;
}
4. Web-Worker-Isolation: 60 FPS fuer die Benutzeroberflaeche
Das Ausfuehren von Matrixmultiplikationen auf dem Haupt-Thread blockiert sofort die Benutzeroberflaeche des Browsers, was zu sichtbarem Ruckeln beim Scrollen und ausgelassenen Frames fuehrt. Um dies zu verhindern, muss die Modellausfuehrung strikt in einem dedizierten Web Worker isoliert werden:
// worker/llm-worker.ts
import { initializeLocalLLM } from '../src/lib/ai/local-llm-engine';

let generator: any = null;

self.onmessage = async (e: MessageEvent) => {
  const { type, payload } = e.data;

  if (type === 'INIT') {
    generator = await initializeLocalLLM((p) => self.postMessage({ type: 'STATUS', payload: p }));
    self.postMessage({ type: 'READY' });
  }

  if (type === 'GENERATE') {
    const { messages, maxTokens = 512 } = payload;
    let startTime = performance.now();
    let tokenCount = 0;

    const output = await generator(messages, {
      max_new_tokens: maxTokens,
      temperature: 0.3,
      streamer: {
        put: (tokens: any) => {
          tokenCount++;
          self.postMessage({ type: 'TOKEN', payload: tokens });
        },
        end: () => {
          const elapsed = (performance.now() - startTime) / 1000;
          self.postMessage({
            type: 'COMPLETE',
            payload: { tokensPerSec: Math.round(tokenCount / elapsed) },
          });
        },
      },
    });
  }
};
5. Persistentes Caching ueber das Origin Private File System (OPFS)
Das Herunterladen eines 650-MB-Modells bei jedem Seitenaufruf wuerde die Nutzerbindung zerstoeren. Moderne Browser unterstuetzen das Origin Private File System (OPFS) und die Cache API, wodurch Modellgewichte einmalig abgerufen und dauerhaft auf dem Speicher des Clients abgelegt werden:
// Pruefen, ob Modellgewichte bereits lokal gecacht sind
export async function isModelCachedLocally(modelId: string): Promise<boolean> {
  const cacheNames = await caches.keys();
  for (const name of cacheNames) {
    if (name.includes(modelId)) return true;
  }
  return false;
}
6. Hybride Fallback-Architektur
In Produktionsumgebungen sollte eine robuste Webanwendung niemals von einer 100%igen WebGPU-Verfuegbarkeit ausgehen. Das empfohlene Architekturmuster ist ein Smart Hybrid Fallback:
User Query
    │
    ▼
Does browser support WebGPU?
    ├── YES ──> Check device memory (> 4GB RAM)
    │               ├── YES ──> In-Browser Local LLM ($0.00 cost, 100% private)
    │               └── NO  ──> Fallback to Cloud RAG API (Gemini / Claude)
    └── NO  ──> Fallback to Cloud RAG API (Gemini / Claude)
Dieses Muster bietet das Beste aus beiden Welten: kostenlose, private Inferenz fuer 80 % der modernen Desktop- und High-End-Mobilnutzer, kombiniert mit einem zuverlaessigen Cloud-Fallback fuer aeltere Geraete.
Wo diese Architektur produktiv eingesetzt wird
Diese Architekturmuster sind keine abstrakte Theorie - sie sind in den folgenden Live-Produkten vollständig implementiert und getestet:
Next.js 16 & Hybrid RAG Portfolio Platform
Nutzt clientseitiges semantisches Vektor-Retrieval im Browser mit Kosinus-Aehnlichkeitsberechnung und Offline-Wissensabgleich.
Fullstack AI Lab
Bietet interaktive clientseitige WebGPU-Neuronale-Netze-Playgrounds mit serverloser Token-Generierung und Echtzeit-Parameteranpassungen.
All Day Medical Care Clinic
Untersuchte HIPAA-konforme Healthcare-Architekturen ohne Datenexfiltration, bei denen Patientensymptome ausschliesslich auf dem Endgeraet analysiert werden.
Planen Sie eine Stack-Migration oder einen Neuaufbau?
Besprechen Sie Ihre Architekturanforderungen mit meinem interaktiven RAG-KI-Assistenten oder kontaktieren Sie mich direkt für eine technische Bewertung.
Weitere Engineering-Artikel
Next.js 16 vs. Headless WordPress vs. Custom PHP: Objektive TCO-, Performance- & SEO-Analyse (2026)
Eine technische Analyse zum Vergleich von Architektur, Wartungsaufwand, Total Cost of Ownership (TCO) und Google Core Web Vitals zwischen Next.js 16, Headless WordPress und individuellem PHP.
Fullstack AI Lab Architektur-Deep-Dive: Kompilierung von 1.135+ MDX-Lektionen in 90 Sekunden mit Next.js 16 & Rust MDX-RS
Vollstaendige technische und strategische Analyse der interaktiven Lernplattform Fullstack AI Lab: Wie wir SSG-Build-Zeiten um das 14-Fache reduzierten (von 21,6 Min. auf 1,5 Min.), eine clientseitige WebAssembly-WordPress-Sandbox entwickelten, einen KI-Interview-Simulator bauten und interaktive Architektur-Visualisierer integrierten.