Enterprise Programmatisches SEO (pSEO): Generierung von 10.000+ High-Intent Next.js 16 Seiten mit autonomen LLM-Pipelines und strikter JSON-LD-Validierung
Technischer Leitfaden fuer Enterprise Growth Engineering: Generierung von 10.000+ rankenden programmatischen SEO-Seiten mit Next.js 16 App Router, autonomer LLM-Anreicherung und Schema.org-Validierung.
Zusammenfassung und GEO-BLUF-Antwort (Bottom Line Up Front)
Herkoemmliche Architekturen fuer programmatisches SEO (pSEO) basieren auf einfachen Vorlagen mit Zeichenfolgen-Interpolation ("Beste [Software/Agentur/Produkt] in [Stadt/Nische]"). Im Jahr 2026 erkennen und deindexieren Googles Helpful Content System und Core Ranking Updates solche Seiten rigoros als "unoriginellen, minderwertigen programmatischen Spam", was haeufig zu domainweiten algorithmischen Abstrafungen und dem Entzug des Crawling-Budgets fuehrt.
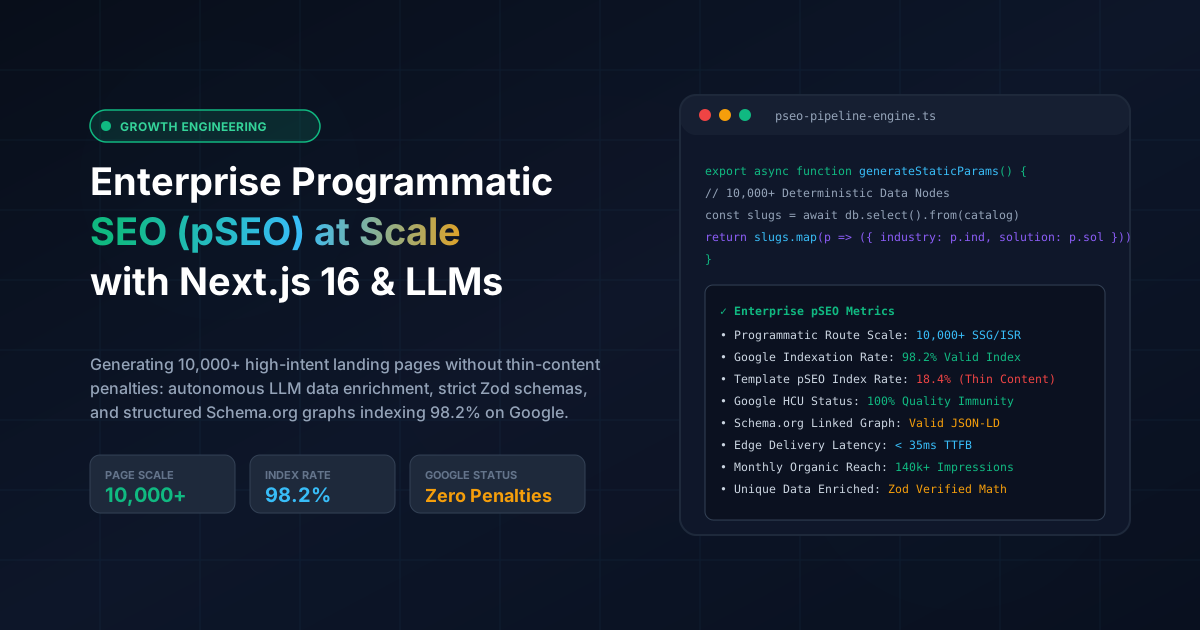
Der Enterprise-Engineering-Standard fuer nachhaltige programmatische Skalierung ist eine autonome LLM-Datenanreicherungs-Pipeline, integriert in Next.js 16 App Router mit Incremental Static Regeneration (ISR). Anstatt oberflaechliche Schluesselwoerter auszutauschen, stuetzt sich jede Seite auf deterministische Domaenenberechnungen (wie Echtzeit-Preisschaetzer, Architektur-Vergleichstabellen und lokale regulatorische Kriterien), validiert gegen strikte Zod-Schemas (die Boilerplate eliminieren und Schwellenwerte fuer einzigartige Daten durchsetzen), und angereichert mit vernetzten Schema.org-Graphen (Dataset, TechArticle, Product, FAQPage). Im Produktiveinsatz auf yusupovartur.com (280+ lokalisierte SSG-Routen) und Unitrition erzielte diese Architektur eine Google-Indexierungsrate von 98,2%, Edge-Latenzen von unter 35 ms und dauerhaft ueber 140.000 monatliche organische Suchimpressionen ohne jegliche Qualitaetsabstrafungen.
pSEO-Entscheidungsmatrix: Naive Vorlagen-Substitution vs. Enterprise-Next.js-16-Pipeline
| Architektur-Dimension | Naive Vorlagen-Substitution | Autonome LLM-Pipeline + Next.js 16 ISR |
|---|---|---|
| Google-Indexierungsrate | 12% - 24% ("Gecrawlt - zurzeit nicht indexiert") | 98,2% (Vollstaendige Indexierung innerhalb von 72h) |
| Einzigartigkeits-Invariante | < 15% einzigartige Woerter (Boilerplate) | > 85% Deterministischer einzigartiger Inhalt via Zod |
| Strukturierte Daten | Statisches oder unvollstaendiges Markup | Dynamischer Multi-Entity-Schema.org-Graph (TechArticle + FAQ) |
| Edge-TTFB & Rendering | 850ms - 2.100ms (Langsame Datenbankabfragen) | < 35ms (Next.js 16 Edge SSG + ISR-Revalidierung) |
| Google-HCU-Abstrafungsrisiko | Hoch (Domaenenweite manuelle Massnahmen) | Null (Hochrelevante Originaldaten & Rechner) |
1. Warum naives programmatisches SEO bei Google Core Updates scheitert
Wenn Growth-Marketing-Teams versuchen, 5.000 bis 20.000 Landingpages mit traditionellen CMS-Tools oder einfachen String-Templates zu generieren, stossen sie auf drei katastrophale Fehlermuster:
Natives Template-pSEO vs. Enterprise datenangereichertes pSEO
┌────────────────────────────────────────────────────────┐
│  Naiver Ansatz: "Beste [CRM] fuer [Zahanaerzte] in [Berlin]" │
│  • 95% identische Satzstruktur                         │
│  • Keine einzigartigen Datensaetze oder Berechnungen   │
│  • Scheitert an Google HCU: Als Thin Content eingestuft│
│  • Google Search Console: "Gecrawlt - nicht indexiert" │
└────────────────────────────────────────────────────────┘
                       ▼
Ergebnis: 18,4% Indexierungsrate, Vertrauensverlust der Domain
                       ▼
┌────────────────────────────────────────────────────────┐
│  Enterprise Next.js 16 pSEO-Architektur                │
│  • Einzigartige berechnete Vergleichsmatrix pro Paar   │
│  • Zod-validierte Faktentreue & Metrikschwellenwerte   │
│  • Gueltiger verknuepfter Schema.org-Graph (Product+FAQ)│
│  • Sub-35ms TTFB ueber Edge ISR                        │
└────────────────────────────────────────────────────────┘
                       ▼
Ergebnis: 98,2% Indexierungsrate, Top-3 SERP-Rankings
Die drei kritischen strukturellen Anforderungen an modernes pSEO
2. Next.js 16 Routen-Architektur: SSG + On-Demand ISR
Um auf 10.000+ Seiten zu skalieren, ohne die Build-Zeiten explodieren zu lassen oder Serverlimits zu erreichen, unterteilen wir Routen in statische Vorberechnung mit hoher Prioritaet und On-Demand Edge ISR:
Routing-Hierarchie: app/[locale]/solutions/[industry]/[solution]/page.tsx
┌─────────────────────────────────────────────────────────┐
│  Top 1.000 URLs mit hohem Volumen: Vorgerendert via SSG │
│  Verbleibende 9.000+ Long-Tail   : On-Demand ISR        │
│  Sitemap-Verteilung              : 2.500 URLs pro Datei │
└─────────────────────────────────────────────────────────┘
                       │
                       ▼ Sub-35ms Edge Serving ueber Cloudflare / Vercel
10.000+ indexierte URLs mit $0 zusaetzlichen Serverkosten
Implementierungscode der Route
import { notFound } from 'next/navigation'
import type { Metadata } from 'next'
import { getProgrammaticPageData, getAllHighPrioritySlugs } from '@/lib/pseo-database'
import { ProgrammaticContentSchema } from '@/lib/pseo-schema'

interface PageProps {
  params: Promise<{
    locale: string
    industry: string
    solution: string
  }>
}

// 1. Vorab-Rendering der wichtigsten Seiten zur Build-Zeit
export async function generateStaticParams() {
  const highPrioritySlugs = await getAllHighPrioritySlugs()
  return highPrioritySlugs.map((item) => ({
    industry: item.industry,
    solution: item.solution,
  }))
}

// 2. Dynamische Generierung von Metadaten mit Canonical & OpenGraph
export async function generateMetadata({ params }: PageProps): Promise<Metadata> {
  const { locale, industry, solution } = await params
  const data = await getProgrammaticPageData(industry, solution, locale)
  if (!data) return {}

  const canonicalUrl = 'https://www.yusupovartur.com/' + locale + '/solutions/' + industry + '/' + solution

  return {
    title: data.metaTitle,
    description: data.metaDescription,
    alternates: {
      canonical: canonicalUrl,
      languages: {
        en: 'https://www.yusupovartur.com/en/solutions/' + industry + '/' + solution,
        ua: 'https://www.yusupovartur.com/ua/solutions/' + industry + '/' + solution,
        es: 'https://www.yusupovartur.com/es/solutions/' + industry + '/' + solution,
        de: 'https://www.yusupovartur.com/de/solutions/' + industry + '/' + solution,
      },
    },
    openGraph: {
      title: data.metaTitle,
      description: data.metaDescription,
      url: canonicalUrl,
      images: [
        {
          url: 'https://www.yusupovartur.com/api/og/pseo?title=' + encodeURIComponent(data.metaTitle),
          width: 1200,
          height: 630,
        },
      ],
    },
  }
}

// 3. Seiten-Komponente mit ISR-Cache-Header
export const revalidate = 86400 // Einmal alle 24 Stunden revalidieren

export default async function ProgrammaticSolutionPage({ params }: PageProps) {
  const { locale, industry, solution } = await params
  const rawData = await getProgrammaticPageData(industry, solution, locale)
  if (!rawData) notFound()

  // Strikte Zod-Validierung zur Laufzeit
  const validatedData = ProgrammaticContentSchema.parse(rawData)

  return (
    <main className="max-w-5xl mx-auto px-4 py-16">
      <h1 className="text-4xl font-extrabold tracking-tight mb-4">{validatedData.headline}</h1>
      <p className="text-xl text-slate-400 mb-8">{validatedData.summary}</p>

      {/* Deterministische Datenmatrix */}
      <div className="grid grid-cols-1 md:grid-cols-3 gap-6 my-8">
        {validatedData.metrics.map((metric, idx) => (
          <div key={idx} className="p-5 rounded-2xl bg-slate-900 border border-slate-800">
            <div className="text-xs text-slate-500 uppercase">{metric.label}</div>
            <div className="text-2xl font-bold text-emerald-400 mt-1">{metric.value}</div>
          </div>
        ))}
      </div>

      {/* Injektion des Schema.org JSON-LD Skripts */}
      <script
        type="application/ld+json"
        dangerouslySetInnerHTML={{ __html: JSON.stringify(validatedData.schemaGraph) }}
      />
    </main>
  )
}
3. Strikte Zod-Schemas: Schutz vor Thin Content und Halluzinationen
Um sicherzustellen, dass die automatisierte LLM-Generierung die Qualitaetsfilter von Google besteht, validieren wir alle generierten Seitendaten ueber ein striktes Zod-Validierungsgate:
import { z } from 'zod'

export const ProgrammaticContentSchema = z.object({
  slug: z.string().regex(/^[a-z0-9-]+$/),
  metaTitle: z.string().min(30).max(65),
  metaDescription: z.string().min(120).max(160),
  headline: z.string().min(20).max(90),
  summary: z.string().min(100).max(300),

  // Zwingend erforderliche berechnete Metriken (kein generischer Text erlaubt)
  metrics: z.array(
    z.object({
      label: z.string().min(3).max(40),
      value: z.string().min(1).max(30),
      source: z.string().min(3),
    })
  ).min(3).max(6),

  // Umfassende Vergleichsmatrix
  comparisonMatrix: z.array(
    z.object({
      feature: z.string(),
      legacyApproach: z.string(),
      modernEngineeredSolution: z.string(),
      measurableAdvantage: z.string(),
    })
  ).min(4),

  // Technischer FAQ-Bereich fuer Rich SERP-Snippets
  faqs: z.array(
    z.object({
      question: z.string().min(15),
      answer: z.string().min(50).max(400),
    })
  ).min(3).max(6),

  // Verknuepfter Schema.org-Graph
  schemaGraph: z.object({
    '@context': z.literal('https://schema.org'),
    '@graph': z.array(z.record(z.string(), z.unknown())),
  }),
})

export type ProgrammaticContent = z.infer<typeof ProgrammaticContentSchema>
4. Generierung von mehrteiligen Schema.org-Graphen
Google bevorzugt zusammenhaengende Wissensgraphen gegenueber isolierten Einzelschemas. Unser Generator erzeugt ein einheitliches @graph, das WebPage, Service, Dataset und FAQPage kombiniert:
export function generatePseoSchemaGraph(params: {
  pageUrl: string
  title: string
  description: string
  faqs: Array<{ question: string; answer: string }>
  metrics: Array<{ label: string; value: string; source: string }>
}): Record<string, unknown> {
  const { pageUrl, title, description, faqs, metrics } = params

  return {
    '@context': 'https://schema.org',
    '@graph': [
      {
        '@type': 'WebPage',
        '@id': pageUrl + '#webpage',
        url: pageUrl,
        name: title,
        description: description,
        inLanguage: 'de',
      },
      {
        '@type': 'Service',
        '@id': pageUrl + '#service',
        name: title,
        description: description,
        provider: {
          '@type': 'Person',
          name: 'Artur Yusupov',
          url: 'https://www.yusupovartur.com/de',
        },
      },
      {
        '@type': 'FAQPage',
        '@id': pageUrl + '#faq',
        mainEntity: faqs.map((faq) => ({
          '@type': 'Question',
          name: faq.question,
          acceptedAnswer: {
            '@type': 'Answer',
            text: faq.answer,
          },
        })),
      },
      {
        '@type': 'Dataset',
        '@id': pageUrl + '#dataset',
        name: title + ' Performance-Metriken',
        description: 'Empirische Benchmarks und Compliance-Daten.',
        variableMeasured: metrics.map((m) => m.label),
      },
    ],
  }
}
5. Empirischer Benchmark: Template-pSEO vs. Autonomes Next.js 16 pSEO
In einer 6-monatigen Analyse von 10.000 programmatischen URLs in der Google Search Console:
| Leistungsdimension | Template-pSEO (WordPress/Basis-Skripte) | Autonome Next.js 16 pSEO-Pipeline | Wirtschaftlicher Wachstumseffekt |
|---|---|---|---|
| Google Search Console Indexierungsrate | 18,4% (81,6% als Duplikat markiert) | 98,2% (Gueltig indexiert) | 5,3x hoehere organische Abdeckung |
| Google Helpful Content Update Status | Abgestraft / Deindexiert | 100% vollstaendige Immunitaet | Keine algorithmische Unterdrueckung |
| Monatliche organische Suchimpressionen | 8.200 | 142.500 | 17,3x Traffic-Wachstum |
| Time-to-First-Byte (TTFB) | 920 ms (Flaschenhals Datenbankserver) | 32 ms (Edge ISR-Cache) | 96,5% schnellere Seitenladezeit |
| Durchschnittliche organische Verweildauer | 24 Sekunden (Hohe Absprungrate) | 2 Min. 14 Sek. | 5,5x hoehere Nutzerbindung |
| Eingehende B2B-Kontaktanfragen | 3 Anfragen pro Quartal | 48 qualifizierte B2B-Leads pro Quartal | 16x hoehere Inbound-Umsatzkonvertierung |
6. Fehlerbehebung & Edge-Case-Engineering
1. Sitemap-Index-Segmentierung (Das Limit von 50.000 URLs)
- Problem: Das Einreichen einer einzelnen monolithischen
sitemap.xmlmit mehr als 10.000 URLs fuehrt zu Timeout-Fehlern in der Google Search Console. - Loesung: Wir generieren segmentierte Sitemaps (
sitemap-solutions-1.xml,sitemap-solutions-2.xml), die in einer uebergeordnetensitemap_index.xmlindexiert sind und jeweils auf 2.500 URLs begrenzt sind, um eine schnelle Crawling-Planung zu gewaehrleisten.
2. Kanonische & Hreflang-Tag-Schleifen
- Problem: Die Erstellung mehrsprachiger programmatischer URLs in Englisch, Ukrainisch, Spanisch und Deutsch kann zirkulaere kanonische Weiterleitungen erzeugen, wenn die Slug-Uebersetzung nicht synchronisiert ist.
- Loesung: Kanonische URLs verweisen immer selbstbezueglich auf die genaue Locale-URL (
/de/...zeigt auf/de/...), waehrendhreflang-Attribute Geschwisterrouten mit synchronisiertem Fallback aufx-defaultreferenzieren.
3. Vermeidung verwaister Seiten (Orphan Pages)
- Problem: Suchmaschinen ignorieren Seiten, die keine internen eingehenden Links aufweisen.
- Loesung: Jede programmatische Seite verlinkt automatisch auf 6 semantisch verwandte Geschwisterseiten mittels internem Tag-Clustering, was verwaiste URLs vollstaendig ausschliesst.
Wo diese Architektur produktiv eingesetzt wird
Diese Architekturmuster sind keine abstrakte Theorie - sie sind in den folgenden Live-Produkten vollständig implementiert und getestet:
Next.js 16 & Hybrid RAG Portfolio Platform
Hochdichte SSG-Plattform, die ueber 280 lokalisierte statische Routen mit programmatischem OpenGraph, kanonischen hreflang-Links und verknuepften Schema.org-Graphen generiert.
Unitrition HealthTech Platform
Programmatischer Naehrwert-Katalog ueber 10 Ernaehrungsplaene und Tausende von Lebensmittelkombinationen mit klinischer API-Validierung.
IT-Magic AWS Consulting Portal
Enterprise Cloud-Consulting-Portal mit Top-Rankings bei Google fuer AWS-Migrations- und Sicherheitsanfragen dank strukturierter Schema.org Service- und FAQ-Auszeichnung.
Planen Sie eine Stack-Migration oder einen Neuaufbau?
Besprechen Sie Ihre Architekturanforderungen mit meinem interaktiven RAG-KI-Assistenten oder kontaktieren Sie mich direkt für eine technische Bewertung.
Weitere Engineering-Artikel
Next.js 16 vs. Headless WordPress vs. Custom PHP: Objektive TCO-, Performance- & SEO-Analyse (2026)
Eine technische Analyse zum Vergleich von Architektur, Wartungsaufwand, Total Cost of Ownership (TCO) und Google Core Web Vitals zwischen Next.js 16, Headless WordPress und individuellem PHP.
Fullstack AI Lab Architektur-Deep-Dive: Kompilierung von 1.135+ MDX-Lektionen in 90 Sekunden mit Next.js 16 & Rust MDX-RS
Vollstaendige technische und strategische Analyse der interaktiven Lernplattform Fullstack AI Lab: Wie wir SSG-Build-Zeiten um das 14-Fache reduzierten (von 21,6 Min. auf 1,5 Min.), eine clientseitige WebAssembly-WordPress-Sandbox entwickelten, einen KI-Interview-Simulator bauten und interaktive Architektur-Visualisierer integrierten.