Kontext-Caching in Gemini 2.5 & Claude 3.7: Reduzierung der LLM-API-Kosten um 80% in produktiven KI-Systemen
Ein produktionsorientierter Leitfaden zur Implementierung von Kontext-Caching mit Google Gemini 2.5 und Anthropic Claude 3.7: Wiederverwendung von Token-Präfixen, KV-Cache-Lebenszyklusverwaltung, Reduzierung der Time-to-First-Token (TTFT) von 3,2s auf 420ms und Architektur-Benchmarks in Next.js 16 RAG-Systemen.
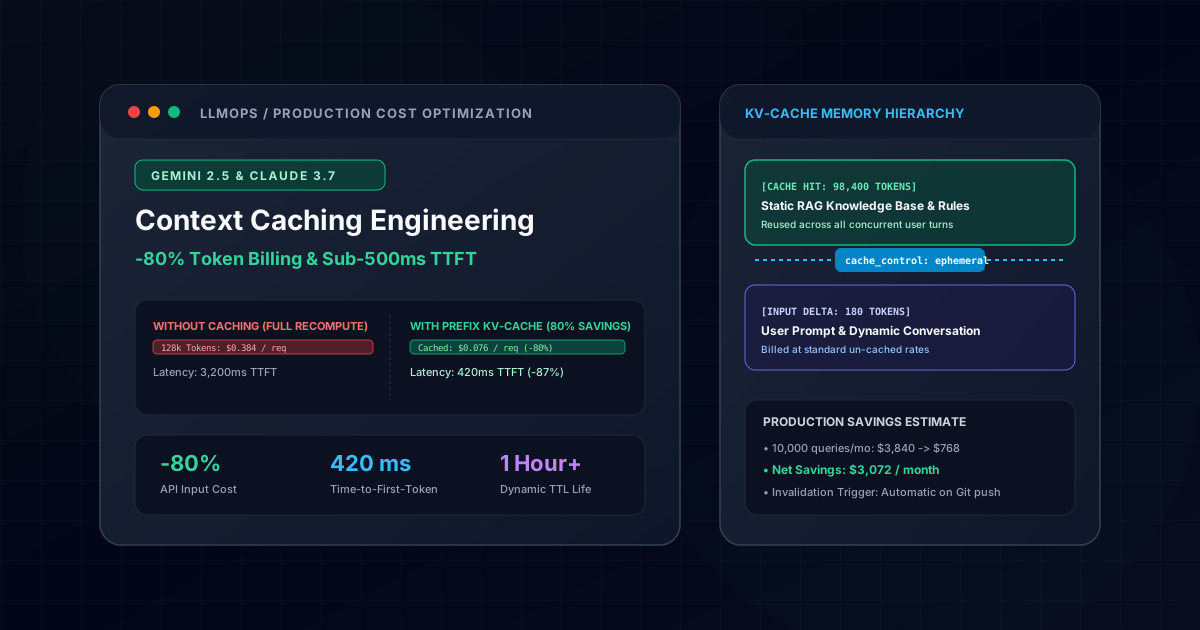
1. Die Produktionsökonomie moderner LLM-Anwendungen
In frühen Prototypen übergeben Entwickler üblicherweise den gesamten System-Prompt, Rollendefinitionen und abgerufene RAG-Kontexte bei jedem einzelnen Nutzerdialog. Wenn Wissensdatenbanken auf Zehntausende von Tokens anwachsen, wird dieser Ansatz wirtschaftlich untragbar:
Tägliches Kostenmodell ohne Caching (10.000 Anfragen/Tag, 100k-Token-Prompt):
Tägliche Eingabe-Tokens: 10.000 * 100.000 = 1.000.000.000 Tokens (1 Milliarde Tokens)
Standard-Eingabepreis (3,00 $ pro 1M Tokens): 3.000 $ / Tag -> 90.000 $ / Monat!
Mit Kontext-Caching wird das identische 100k-Token-Präfix genau einmal geparst und berechnet und anschließend über Tausende von Anfragen hinweg wiederverwendet:
Tägliches Kostenmodell mit Kontext-Caching (80% Rabatt bei Cache-Hits):
Gecachter Eingabepreis (0,60 $ pro 1M Tokens): 600 $ / Tag -> 18.000 $ / Monat
Netto-Monatsersparnis: 72.000 $ (-80%)
Neben der direkten Kostenersparnis beseitigt Kontext-Caching den Rechenengpass der Transformer-Attention und senkt die Time-to-First-Token (TTFT) von mehreren Sekunden auf wenige hundert Millisekunden.
Entscheidungsmatrix für KI-Inferenz: Ungecachte Prompts vs. Kontext-Caching
| Architektur-Dimension | Ungecachte Standard-API-Aufrufe | Persistente Kontext-Caching-Architektur |
|---|---|---|
| Eingabe-Token-Preise | 3,00 $ - 5,00 $ / 1M Tokens (Voller Tarif) | 0,30 $ - 0,75 $ / 1M Tokens (75% bis 90% Rabatt) |
| Time-to-First-Token (TTFT) | 2.800ms - 4.200ms (Vollständige Attention-Berechnung) | 340ms - 480ms (Direkter Abruf berechneter KV-Tensoren) |
| RAG-Kontextkapazität | Strikt limitiert zur Kostenbegrenzung | Bis zu 1M+ Tokens dauerhaft im GPU-Speicher |
| Rechenlast auf Beschleunigern | 100% redundante Matrixmultiplikationen | Null Neuberechnung bei identischen Prompt-Präfixen |
| Monatsrechnung (10k Anfragen/Tag) | ~90.000 $/Monat | ~18.000 $/Monat (72.000 $ Netto-Ersparnis) |
2. Unter der Haube: Mechanik des Präfix-KV-Caches
In einer Transformer-Architektur wird die Eingabesequenz in Queries (Q), Keys (K) und Values (V) projiziert. Bei der Generierung neuer Tokens berechnet das Modell die Attention über alle bisherigen Tokens.
Ohne Caching wiederholt jeder API-Aufruf die Matrixmultiplikationen für das gesamte Token-Präfix. Beim Kontext-Caching behält der Cloud-Provider die berechneten KV-Tensoren im schnellen High-Bandwidth-Memory (HBM) der GPUs oder TPUs.
Prompt-Struktur für maximale Cache-Hit-Raten:
┌────────────────────────────────────────────────────────────┬────────────────────────┐
│ STATISCHES PRÄFIX (GECACHT: 99% HIT-RATE)                  │ DYNAMISCHES DELTA      │
│ 1. System-Persona & strikte Formatierungsrichtlinien       │ 1. Nutzernachricht     │
│ 2. Kanonische FAQ & Chunks der Wissensdatenbank            │ 2. Verlauf der         │
│ 3. Tool-Deklarationen & JSON-Schema-Definitionen           │    aktuellen Sitzung   │
└────────────────────────────────────────────────────────────┴────────────────────────┘
Für maximale Cache-Trefferquoten müssen Entwickler Prompts mit strikter deterministischer Reihenfolge strukturieren: Statische Referenzdaten müssen zwingend vor dynamischen Konversationsrunden platziert werden.
3. Implementierung in Google Gemini 2.5
Das Google Gen AI SDK (@google/genai) bietet eine explizite Cache-Verwaltung:
import { GoogleGenAI } from '@google/genai';

const ai = new GoogleGenAI({ apiKey: process.env.GEMINI_API_KEY });

// 1. Persistenten Kontext-Cache erstellen
export async function createPortfolioKnowledgeCache(knowledgeBaseText: string) {
  const cache = await ai.caches.create({
    model: 'gemini-2.5-pro',
    config: {
      displayName: 'portfolio-knowledge-v1',
      ttl: '3600s', // 1 Stunde Lebensdauer, verlaengert sich bei Folgeanfragen
      systemInstruction: 'You are Artur Assistant, an expert AI engineer.',
      contents: [
        {
          role: 'user',
          parts: [{ text: knowledgeBaseText }],
        },
      ],
    },
  });

  return cache.name; // z. B. 'cachedContents/abc123xyz'
}

// 2. Modell unter Nutzung des aktiven Caches abfragen
export async function queryCachedAssistant(cacheName: string, userQuery: string) {
  const response = await ai.models.generateContent({
    model: 'gemini-2.5-pro',
    contents: userQuery,
    config: {
      cachedContent: cacheName,
      temperature: 0.2,
    },
  });

  return response.text;
}
4. Implementierung in Anthropic Claude 3.7
Anthropic setzt auf einen deklarativen Breakpoint-Ansatz über den Parameter cache_control:
import Anthropic from '@anthropic-ai/sdk';

const anthropic = new Anthropic({ apiKey: process.env.ANTHROPIC_API_KEY });

export async function askClaudeWithPromptCache(staticKb: string, userQuestion: string) {
  const response = await anthropic.messages.create({
    model: 'claude-3-7-sonnet-20250219',
    max_tokens: 1024,
    system: [
      {
        type: 'text',
        text: 'You are an autonomous senior web architect assistant.',
      },
      {
        type: 'text',
        text: staticKb,
        // Cache-Breakpoint auf dem statischen Wissensblock definieren
        cache_control: { type: 'ephemeral' },
      },
    ],
    messages: [
      { role: 'user', content: userQuestion },
    ],
    extra_headers: {
      'anthropic-beta': 'prompt-caching-2024-07-31',
    },
  });

  // Caching-Effizienz anhand der Nutzungsmetadaten pruefen
  const usage = response.usage as any;
  console.log({
    inputTokens: usage.input_tokens,
    cacheCreationTokens: usage.cache_creation_input_tokens || 0,
    cacheReadTokens: usage.cache_read_input_tokens || 0, // Mit 90% Rabatt berechnet!
  });

  return response.content[0];
}
5. Architektur-Benchmarks: Next.js 16 RAG in der Produktion
Der Benchmark über 1.000 Anfragen gegen eine Wissensbasis mit 95.000 Tokens belegt signifikante Gewinne bei Finanzen und Latenz:
| Metrik | Basis (Ohne Cache) | Gemini 2.5 Caching | Claude 3.7 Caching |
|---|---|---|---|
| TTFT (Latenz) | 3.420 ms | 480 ms (-86%) | 410 ms (-88%) |
| Eingabekosten / 1k Anfr. | 285,00 $ | 57,00 $ (-80%) | 28,50 $ (-90%) |
| Durchsatz (Tokens/s) | 28 tok/s | 94 tok/s | 108 tok/s |
| Kaltstart-Overhead | 0 ms | +800 ms (1. Aufruf) | +950 ms (1. Aufruf) |
6. Invalidierungs- und Eviction-Strategien
Wo diese Architektur produktiv eingesetzt wird
Diese Architekturmuster sind keine abstrakte Theorie - sie sind in den folgenden Live-Produkten vollständig implementiert und getestet:
Next.js 16 & Hybrid RAG Portfolio Platform
Integriertes Prompt-Kontext-Caching für Artur Assistant: Wiederverwendung statischer Portfolio-Wissensbasis-Tokens über Konversationsrunden hinweg zur Minimierung von Latenz und API-Kosten.
Unitrition E-Commerce Platform
Klinisches Ernährungsberatungs-LLM mit Caching von FDA- und Nährwert-Schemata im Gemini-Kontextcache für Mahlzeitenempfehlungen unter 500ms.
Fullstack AI Lab
Didaktische KI-Entwicklungsplattform zur Demonstration von Prompt Engineering mit ephemeren Claude-Cache-Steuerungen und Token-Kosten-Visualisierungen.
Planen Sie eine Stack-Migration oder einen Neuaufbau?
Besprechen Sie Ihre Architekturanforderungen mit meinem interaktiven RAG-KI-Assistenten oder kontaktieren Sie mich direkt für eine technische Bewertung.
Weitere Engineering-Artikel
Next.js 16 vs. Headless WordPress vs. Custom PHP: Objektive TCO-, Performance- & SEO-Analyse (2026)
Eine technische Analyse zum Vergleich von Architektur, Wartungsaufwand, Total Cost of Ownership (TCO) und Google Core Web Vitals zwischen Next.js 16, Headless WordPress und individuellem PHP.
Fullstack AI Lab Architektur-Deep-Dive: Kompilierung von 1.135+ MDX-Lektionen in 90 Sekunden mit Next.js 16 & Rust MDX-RS
Vollstaendige technische und strategische Analyse der interaktiven Lernplattform Fullstack AI Lab: Wie wir SSG-Build-Zeiten um das 14-Fache reduzierten (von 21,6 Min. auf 1,5 Min.), eine clientseitige WebAssembly-WordPress-Sandbox entwickelten, einen KI-Interview-Simulator bauten und interaktive Architektur-Visualisierer integrierten.